






实现自定义 writer 需要继承抽象类 java.io.writer,并实现其核心方法 write(char[] cbuf, int off, int len)、flush() 和 close()。由于 writer 是面向字符的流,通常建议组合一个 outputstream(如 fileoutputstream)并在内部使用 outputstreamwriter 或手动处理编码转换,从而复用底层的字节写入逻辑。

如何重写 write 方法以支持缓冲输出
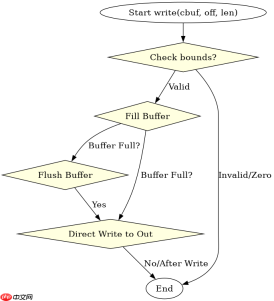
通过维护一个字符缓冲区 char[] 和计数器,可以在 write 方法中累积数据,当缓冲区满时再调用 flush 将数据转换为字节写出。这种方式能显著减少底层 I/O 操作的次数,提升性能。在实现时,需确保线程安全或使用同步块保护缓冲区状态。
import java.io.*;

public class BufferedCustomWriter extends Writer {
    private final OutputStream out;
    private final char[] buffer;
    private int count = 0;

    public BufferedCustomWriter(OutputStream out, int bufferSize) {
        super.lock = this; // 确保同步锁正确
        this.out = out;
        this.buffer = new char[bufferSize];
    }

    @Override
    public void write(char[] cbuf, int off, int len) throws IOException {
        if ((off  cbuf.length) || (len  cbuf.length) || ((off + len) = buffer.length) {
            flushBuffer();
            out.write(new String(cbuf, off, len).getBytes("UTF-8"));
            return;
        }
        // 填充缓冲区
        int spaceLeft = buffer.length - count;
        if (len >= spaceLeft) {
            System.arraycopy(cbuf, off, buffer, count, spaceLeft);
            flushBuffer();
            System.arraycopy(cbuf, off + spaceLeft, buffer, 0, len - spaceLeft);
        } else {
            System.arraycopy(cbuf, off, buffer, count, len);
            count += len;
        }
    }

    @Override
    public void flush() throws IOException {
        synchronized (lock) {
            flushBuffer();
            out.flush();
        }
    }

    @Override
    public void close() throws IOException {
        synchronized (lock) {
            flushBuffer();
            out.close();
        }
    }

    private void flushBuffer() throws IOException {
        if (count > 0) {
            out.write(new String(buffer, 0, count).getBytes("UTF-8"));
            count = 0;
        }
    }

    public static void main(String[] args) throws IOException {
        try (BufferedCustomWriter writer = new BufferedCustomWriter(new FileOutputStream("test.txt"), 1024)) {
            writer.write(new char[]{'H', 'e', 'l', 'l', 'o'}, 0, 5);
            writer.flush();
        }
    }
}
如何处理编码转换与异常
在将字符转换为字节时,必须指定明确的字符集(如 UTF-8),否则可能因平台默认编码不同导致乱码。同时,write 方法中的索引检查是必须的,以防止数组越界。若底层 OutputStream 抛出异常,应直接向上抛出,由调用者处理。对于 flush 和 close,需确保缓冲区中的数据被完全写出,且资源被正确释放。

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
import java.io.*;

public class EncodingAwareWriter extends Writer {
    private final OutputStream out;
    private final Charset charset;

    public EncodingAwareWriter(OutputStream out, Charset charset) {
        super.lock = this;
        this.out = out;
        this.charset = charset;
    }

    @Override
    public void write(char[] cbuf, int off, int len) throws IOException {
        if (cbuf == null) {
            throw new NullPointerException();
        }
        out.write(new String(cbuf, off, len).getBytes(charset));
    }

    @Override
    public void flush() throws IOException {
        out.flush();
    }

    @Override
    public void close() throws IOException {
        out.close();
    }

    public static void main(String[] args) throws IOException {
        try (EncodingAwareWriter writer = new EncodingAwareWriter(new FileOutputStream("test_utf8.txt"), java.nio.charset.StandardCharsets.UTF_8)) {
            writer.write(new char[]{'A', 'B', 'C'}, 0, 3);
        }
    }
}
基于缓冲区满条件时的具体行为问题
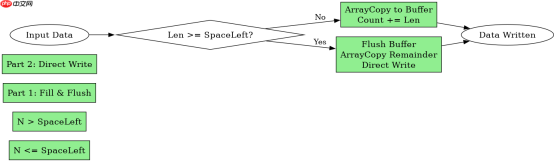
当写入的数据量超过缓冲区大小时,程序会先刷新当前缓冲区内容,然后将剩余数据直接写入底层流。这种设计避免了为超大单次写入分配过大内存,同时保证了数据的顺序性。在实际使用中,若传入的 len 大于缓冲区剩余空间,代码会分两部分处理:先填满缓冲区并刷新,再将剩余部分直接写出。这确保了即使是大块数据也能被正确处理,而不会丢失或错位。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


