






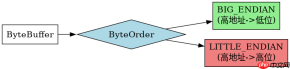
java nio 中 bytebuffer 的 big_endian(大端)和 little_endian(小端)决定了多字节基本类型数据在内存中的存储顺序。调用 order(byteorder) 方法可以切换当前缓冲区的字节序,这直接影响后续读取或写入整数、浮点数等复合类型时的结果。
大端模式下的字节存储与读取逻辑是什么
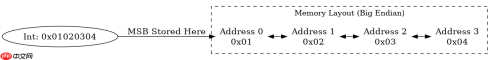
在大端模式(BIG_ENDIAN)下,数据的高位字节存储在低地址,低位字节存储在高地址,这符合人类阅读数字的习惯。当缓冲区处于此模式时,写入一个 int 值会按从高到低的顺序排列字节,读取时也会还原为正确的数值。
import java.nio.ByteBuffer;
import java.nio.ByteOrder;

public class BigEndianDemo {
    public static void main(String[] args) {
        // 创建容量为4字节的缓冲区
        ByteBuffer buffer = ByteBuffer.allocate(4);

        // 显式设置为大端模式(默认即为大端)
        buffer.order(ByteOrder.BIG_ENDIAN);

        // 写入整数 0x01020304
        int value = 0x01020304;
        buffer.putInt(value);

        // 重置位置以便读取
        buffer.flip();

        // 读取并验证
        int readValue = buffer.getInt();
        System.out.println("Read: " + Integer.toHexString(readValue));

        // 查看底层字节数组
        byte[] bytes = buffer.array();
        System.out.print("Bytes: ");
        for (byte b : bytes) {
            System.out.printf("%02X ", b & 0xFF);
        }
    }
}
小端模式如何改变数据的内存布局
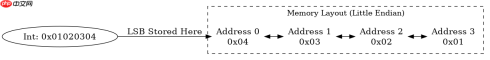
在小端模式(LITTLE_ENDIAN)下,数据的低位字节存储在低地址,高位字节存储在高地址。这种模式常见于 x86 架构的处理器。切换到此模式后,相同的整数值在缓冲区中的字节排列将完全反转,导致直接读取原始字节数组时得到不同的视觉序列,但通过 getInt() 等方法读取时仍能正确还原数值。

javascript-typescript-typescript-scaffold
下载
你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
import java.nio.ByteBuffer;
import java.nio.ByteOrder;

public class LittleEndianDemo {
    public static void main(String[] args) {
        ByteBuffer buffer = ByteBuffer.allocate(4);

        // 切换为小端模式
        buffer.order(ByteOrder.LITTLE_ENDIAN);

        // 写入相同的整数 0x01020304
        int value = 0x01020304;
        buffer.putInt(value);

        buffer.flip();

        // 读取验证
        int readValue = buffer.getInt();
        System.out.println("Read: " + Integer.toHexString(readValue));

        // 查看底层字节数组
        byte[] bytes = buffer.array();
        System.out.print("Bytes: ");
        for (byte b : bytes) {
            System.out.printf("%02X ", b & 0xFF);
        }
    }
}
混合使用不同字节序读取同一缓冲区会发生什么
如果在同一个 ByteBuffer 中先以大端模式写入数据,然后切换为小端模式进行读取,或者反之,会导致解析出的数值错误。这是因为 order() 仅影响复合类型的读写解释方式,而不改变底层字节数组的物理存储。若强行用错误的字节序解读数据,得到的将是无意义的乱码数值,除非你明确知道数据是以相反字节序编码的。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


