






javascript web worker 无法直接传递 idbkeyrange 对象,因为它是非结构化克隆算法不支持的 dom 接口。正确的做法是在主线程中将其转换为纯数据格式(如包含 lower、upper、loweropen、upperopen 属性的对象),通过 postmessage 发送,worker 收到后使用构造函数重新实例化。

如何序列化 IDBKeyRange 对象
要将 IDBKeyRange 传递给 Worker,需要提取其四个核心属性:lower(下界)、upper(上界)、lowerOpen(下界是否开区间)和 upperOpen(上界是否开区间)。这些属性构成了该范围的全部逻辑信息,足以在另一端重建相同的查询条件。
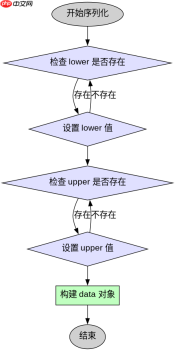
const range = IDBKeyRange.bound(10, 20, false, false); const data = { lower: range.lower, upper: range.upper, lowerOpen: range.lowerOpen, upperOpen: range.upperOpen }; worker.postMessage({ type: 'query', rangeData: data });
上述代码展示了如何将一个闭区间 [10, 20] 转换为可传输的数据包。注意,如果范围是单边或开闭区间,对应的 lower/upper 可能为 undefined,而布尔值会如实反映开闭状态。这种结构保证了所有边界情况都能被准确描述。
Worker 端如何反序列化并执行查询
Worker 接收到数据后,必须使用 new IDBKeyRange() 构造函数将数据还原为真正的 IDBKeyRange 实例。只有实例化的对象才能被 IndexedDB API 接受用于 openCursor 或 getAll 等方法。直接使用原始数据对象会导致类型错误。

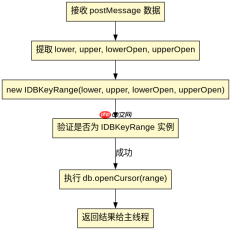
self.onmessage = function(e) { if (e.data.type === 'query') { const { lower, upper, lowerOpen, upperOpen } = e.data.rangeData; const range = new IDBKeyRange(lower, upper, lowerOpen, upperOpen); // 使用 range 进行数据库操作 }};
这里的关键在于构造函数的参数顺序与 IDBKeyRange 静态方法(如 bound、only)不同。构造函数始终按 (lower, upper, lowerOpen, upperOpen) 的顺序接收参数。即使某些值为 undefined,构造函数也能正确处理,生成对应类型的 Range 对象。例如,若 lower 为 undefined,则生成的 Range 无下界限制。
处理 undefined 边界值的实际行为
当传入的 lower 或 upper 为 undefined 时,IDBKeyRange 构造函数会生成单边或双边无界的范围。这在分页或全表扫描场景中非常有用。例如,仅指定 upper 可以获取所有小于某值的记录,而不必关心下界。
// 模拟 Worker 内部逻辑 function createRangeFromData(data) { return new IDBKeyRange( data.lower, data.upper, data.lowerOpen, data.upperOpen ); } // 测试:无上界 const r1 = createRangeFromData({ upper: 50, lowerOpen: false, upperOpen: true }); console.log(r1.lower); // undefined console.log(r1.upper); // 50 console.log(r1.lowerOpen); // false console.log(r1.upperOpen); // true
运行结果显示,r1.lower 确实为 undefined,表明该范围从负无穷开始。这种机制允许前端灵活定义查询范围,而无需在 Worker 中编写复杂的条件判断逻辑来区分“未设置”和“显式设为 null”。需要注意的是,IDBKeyRange 不接受 null 作为边界值,必须使用 undefined 来表示缺失边界。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





