






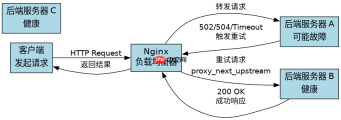
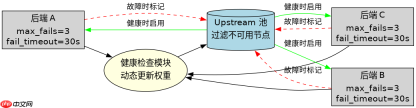
在 nginx 中,通过配置 proxy_next_upstream 指令并配合健康检查机制,可以实现当后端服务器返回特定错误(如 502、504)或发生连接超时等故障时,自动将请求转发给下一个可用的上游服务器,从而实现无缝重试。具体做法是在 upstream 块中定义后端列表,并在 location 块中设置该指令以指定触发重试的条件(如 error、timeout),同时建议结合 max_fails 和 fail_timeout 参数来动态剔除暂时不可用的节点,确保流量只路由到健康的实例。
如何配置 proxy_next_upstream 以捕获常见 HTTP 错误
要捕获常见的 HTTP 错误(如 502 Bad Gateway 或 504 Gateway Timeout)并触发重试,需要在 location 块中显式列出这些状态码。默认情况下,Nginx 仅对连接错误和超时进行重试,不包含 HTTP 错误码,因此必须手动添加 http_502 和 http_504 等选项。这样,当第一个后端返回这些错误时,Nginx 会立即尝试下一个后端,直到成功或耗尽所有可用节点。
server {
    listen 80;

    location /api/ {
        proxy_pass http://backend_pool;

        # 配置故障转移条件:包括连接错误、超时以及特定的 HTTP 状态码
        proxy_next_upstream error timeout http_502 http_504;

        # 限制最大重试次数,防止无限循环(Nginx 1.17.6+ 支持 max_retries)
        proxy_next_upstream_tries 3;
    }
}

upstream backend_pool {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.12:8080 max_fails=3 fail_timeout=30s;
}
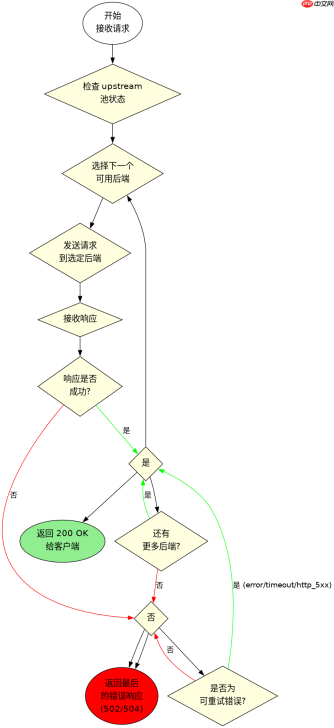
上述配置中,proxy_next_upstream 定义了触发重试的事件集合。当客户端请求 /api/ 时,如果 192.168.1.10 返回 502 或 504,Nginx 会自动将请求发送给 192.168.1.11。如果 192.168.1.11 也失败,则继续尝试 192.168.1.12。proxy_next_upstream_tries 限制了总的尝试次数,避免在全部后端都故障时无限重试消耗资源。upstream 块中的 max_fails 和 fail_timeout 用于标记后端的健康状态,如果在 fail_timeout 时间内连续失败 max_fails 次,该节点将被暂时从池中移除。
如何处理非 HTTP 协议或底层连接故障的重试逻辑
除了 HTTP 状态码,proxy_next_upstream 还能处理底层的连接故障,例如 TCP 连接被拒绝、连接重置或读取超时。这些情况通常由 error 和 timeout 关键字覆盖。在处理非 HTTP 协议(如 gRPC 或自定义 TCP 代理)时,由于没有 HTTP 状态码,主要依赖 error 和 timeout 来判断是否重试。此外,可以通过 non_idempotent 选项允许对非幂等请求(如 POST)进行重试,但需谨慎使用以避免数据重复提交。

# 针对 gRPC 或非 HTTP 服务的配置示例
upstream grpc_backend {
    server 10.0.0.1:9090;
    server 10.0.0.2:9090;
}

server {
    listen 9090;
    location /grpc.service {
        proxy_pass http://grpc_backend;

        # 仅基于连接错误和超时进行重试,不依赖 HTTP 状态码
        proxy_next_upstream error timeout;

        # 注意:对于非幂等请求,默认不会重试,除非显式添加 non_idempotent
        # proxy_next_upstream error timeout non_idempotent;
    }
}
在上述 gRPC 示例中,proxy_next_upstream 仅包含 error 和 timeout。这意味着只有当 Nginx 无法与后端建立连接或读取响应超时时,才会触发重试。如果后端返回了明确的业务错误(如 gRPC 的状态码),Nginx 默认不会重试,因为这不是网络层面的故障。如果需要重试非幂等的 POST 请求,可以添加 non_idempotent,但这可能导致重复的数据写入,需确保应用层有幂等性设计或去重机制。
当所有上游服务器均故障时,proxy_next_upstream 的最终行为是什么
当所有配置的上游服务器都因故障被标记为不可用,或者每次重试都返回相同的错误时,proxy_next_upstream 将停止重试,并将最后一个上游服务器的响应直接返回给客户端。此时,客户端收到的是最后一个失败节点的错误信息(如 502 或 504),而不是 Nginx 生成的通用错误页。这种行为确保了错误信息的准确性,便于前端或客户端根据具体的错误码进行相应的处理,如显示“服务暂时不可用”或触发客户端侧的重试逻辑。


