






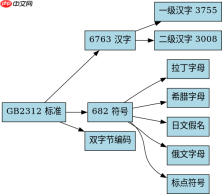
gb2312 是 1980 年发布的简体中文编码标准,全称为《信息交换用汉字编码字符集·基本集》,收录了 6763 个常用汉字和 682 个非汉字字符。在 java 中,它对应 "gb2312" 或 "iso-8859-gb" 字符集名称,主要用于处理早期简体中文环境下的文本数据。
Java 中如何指定 GB2312 编码进行读写操作
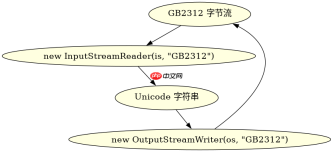
在 Java 中处理 GB2312 编码的文件或网络流时,需要显式指定编码格式以避免使用平台默认编码导致的乱码。通常通过 InputStreamReader、OutputStreamWriter 或 String 的构造方法来实现。
import java.io.*;

public class GB2312Example {
    public static void main(String[] args) throws IOException {
        // 模拟 GB2312 编码的字节数组("中"字的 GB2312 编码为 D6 D0)
        byte[] gb2312Bytes = new byte[] { (byte)0xD6, (byte)0xD0 };

        // 将 GB2312 字节解码为字符串
        String text = new String(gb2312Bytes, "GB2312");
        System.out.println("解码结果: " + text);

        // 将字符串重新编码为 GB2312 字节
        byte[] encodedBytes = text.getBytes("GB2312");
        System.out.println("编码后字节长度: " + encodedBytes.length);
    }
}
上述代码展示了如何将 GB2312 字节流转换为 Java 内部的 Unicode 字符串,以及反向转换。关键点在于 new String(bytes, "GB2312") 和 text.getBytes("GB2312") 这两个 API 调用。如果省略编码参数,Java 会使用系统默认编码(如 Windows 上的 GBK 或 Linux 上的 UTF-8),这可能导致中文显示为乱码。
GB2312 与 GBK、UTF-8 的兼容性及差异
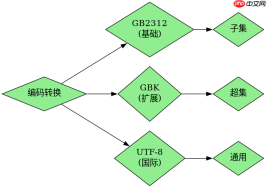
GB2312 是 GBK 的子集,GBK 扩展了 GB2312 以支持更多汉字和繁体字。UTF-8 则是全球通用的变长编码。在 Java 中,理解它们之间的转换关系对于数据迁移至关重要。

import java.nio.charset.Charset;
import java.util.Arrays;

public class EncodingComparison {
    public static void main(String[] args) throws Exception {
        String chineseChar = "汉";

        // 获取不同编码下的字节表示
        byte[] gb2312Bytes = chineseChar.getBytes("GB2312");
        byte[] gbkBytes = chineseChar.getBytes("GBK");
        byte[] utf8Bytes = chineseChar.getBytes("UTF-8");

        System.out.println("GB2312 字节: " + Arrays.toString(gb2312Bytes));
        System.out.println("GBK 字节: " + Arrays.toString(gbkBytes));
        System.out.println("UTF-8 字节: " + Arrays.toString(utf8Bytes));

        // 验证 GB2312 是否包含所有 GBK 字符
        System.out.println("GB2312 是否支持 '汉': " + Charset.forName("GB2312").newEncoder()
            .canEncode(chineseChar.charAt(0)));
    }
}
运行结果显示,"汉"字在 GB2312 和 GBK 中的编码相同(均为 C4 DA),因为 GB2312 包含了该字。但在 UTF-8 中,它占用三个字节(E6 B1 89)。需要注意的是,GB2312 无法编码 GBK 中新增的生僻字,尝试对不支持的字符使用 GB2312 编码会抛出 MalformedInputException 或产生替换字符。因此,在处理现代文本时,建议优先使用 UTF-8,仅在兼容旧系统时才使用 GB2312。
当输入包含 GB2312 不支持的字符时会发生什么
如果输入的字符串中包含 GB2312 字符集未定义的字符(如部分生僻汉字、繁体字或 Emoji),Java 在编码时会抛出异常或返回替换字符。具体行为取决于使用的 API。
import java.io.UnsupportedEncodingException;

public class UnsupportedCharTest {
    public static void main(String[] args) throws UnsupportedEncodingException {
        String text = "测试生僻字: ?"; // ? 是 GB2312 不支持的字符
        try {
            byte[] bytes = text.getBytes("GB2312");
            System.out.println("编码成功: " + bytes.length);
        } catch (UnsupportedEncodingException e) {
            System.out.println("编码失败: " + e.getMessage());
        }

        // 使用 OutputStreamWriter 时的行为
        java.io.ByteArrayOutputStream baos = new java.io.ByteArrayOutputStream();
        java.io.OutputStreamWriter osw = new java.io.OutputStreamWriter(baos, "GB2312");
        try {
            osw.write(text);
            osw.flush();
            System.out.println("Writer 编码后字节数: " + baos.size());
        } catch (java.io.IOException e) {
            System.out.println("Writer 编码异常: " + e.getMessage());
        }
    }
}
在上述代码中,String.getBytes("GB2312") 方法在遇到不支持的字符时,默认会抛出 UnsupportedEncodingException。而使用 OutputStreamWriter 时,可以通过设置 CodingErrorAction 来控制行为,例如忽略错误或使用替换字符。在实际开发中,应提前检查字符集支持情况,或在必要时切换到 GBK/UTF-8 以确保兼容性。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


