






java jdbc 处理批量操作事务数据地图的核心做法是关闭自动提交,将多条 sql 加入同一个 batch,并在执行完毕后统一提交或回滚。具体实现时,通过 connection 调用 setautocommit(false) 开启事务,使用 addbatch() 累积操作,最后调用 executebatch() 一次性发送给数据库。若过程中发生异常,需捕获并调用 rollback() 确保数据一致性;成功则调用 commit() 持久化所有变更。

JDBC 中如何配置批量插入的事务边界
在 JDBC 中配置批量插入的事务边界,关键在于显式管理 Connection 的提交模式。默认情况下,JDBC 连接处于自动提交状态,每条语句都会立即生效,这会导致批量操作失去事务保护且性能低下。要构建事务边界,必须在获取连接后立即禁用自动提交,并将所有批量指令包裹在 try-catch-finally 块中,以确保资源释放和事务状态的最终一致性。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class JdbcBatchTransaction {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交,开启事务
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name, age) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                // 2. 添加批量数据
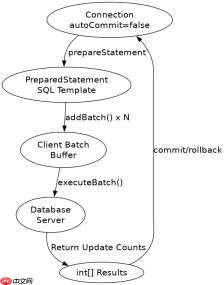
                for (int i = 0; i <p>上述代码展示了标准的 JDBC 批量事务流程。首先通过 <code>setAutoCommit(false)</code> 锁定事务上下文。接着,循环调用 <code>addBatch()</code> 将 SQL 参数化请求暂存于客户端缓冲区。当循环结束,<code>executeBatch()</code> 将所有缓存的命令打包发送至数据库服务器。如果执行过程中抛出 <code>SQLException</code>,程序进入 <code>catch</code> 块并触发 <code>conn.rollback()</code>,撤销该事务内所有已执行的 DML 操作,从而保证“全有或全无”的数据一致性。最后,正常路径下调用 <code>commit()</code> 使变更永久生效。</p><h2>批量操作中如何处理部分失败与结果映射</h2><p>在处理批量操作时,部分失败是指批量中的某些记录因约束冲突、类型错误等原因导致单条执行失败,但整体事务仍需决定是全部回滚还是继续处理。JDBC 的 <code>executeBatch()</code> 返回一个 <code>int[]</code> 数组,其中每个元素对应一条语句的执行状态。成功执行的语句返回正整数(通常表示受影响行数),而失败或受 <code>Statement.SUCCESS_NO_INFO</code> 影响的语句会返回特定常量。开发者需要遍历这个结果数组来识别哪些操作成功、哪些失败,进而决定后续策略。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill11083" title="Java调试"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20dbae7c507.jpg" alt="Java调试" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill11083" title="Java调试" class="overflowclass">Java调试</a>
													<p class="overflowclass">通过 JDWP 实现 Java 远程调试:连接远程 JVM、设置断点、单步执行代码、查看变量值、获取调用栈。适用于需要调试远程 Java 应用、排查运行时状态、追踪代码执行流程的场景。
术语注解
JDWP:Java Debug Wire Protocol,Java 调试有线协议(Java 远程调试底层通信协议)
remote JVM:远程 Java 虚拟机
step through code:代码单步调试(步入 / 步过 / 步出调试)
inspect variables:变量查看 / 变量检视
stac</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill11083" title="Java调试" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div><p><img src="https://img.php.cn/upload/article/001/242/473/179428699849396.png?x-oss-process=image/resize,p_40" alt="Java JDBC 怎么处理批量操作事务数据地图"></p><pre class="brush:php;toolbar:false;">import java.sql.BatchUpdateException;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.Statement;

public class JdbcBatchPartialFailure {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            String sql = "INSERT INTO users (id, name) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                // 模拟数据:第一条正常,第二条主键冲突,第三条正常
                pstmt.setInt(1, 1); pstmt.setString(2, "Alice"); pstmt.addBatch();
                pstmt.setInt(1, 1); pstmt.setString(2, "Bob");   pstmt.addBatch(); // Duplicate Key
                pstmt.setInt(1, 3); pstmt.setString(2, "Charlie"); pstmt.addBatch();

                try {
                    int[] results = pstmt.executeBatch();
                    conn.commit();

                    // 分析结果
                    for (int i = 0; i = 0) {
                            System.out.println("Item " + i + ": Success, rows affected: " + results[i]);
                        } else {
                            System.out.println("Item " + i + ": Failed with code: " + results[i]);
                        }
                    }
                } catch (BatchUpdateException e) {
                    // 捕获批量更新异常,获取部分结果
                    int[] partialResults = e.getUpdateCounts();
                    System.out.println("BatchUpdateException caught. Partial results:");
                    for (int i = 0; i <p>当批量执行遇到错误时,JDBC 驱动通常会抛出 <code>BatchUpdateException</code>。这个异常对象包含了一个 <code>getUpdateCounts()</code> 方法,返回一个 <code>int[]</code>,记录了直到失败点为止各条语句的状态。例如,在上述代码中,如果第二条记录因主键冲突失败,<code>executeBatch()</code> 可能不会立即抛出异常(取决于驱动配置),或者抛出异常后通过 <code>BatchUpdateException</code> 提供前几条的成功计数。开发者应检查返回值是否等于 <code>Statement.SUCCESS_NO_INFO</code>(值为 -2)或 <code>Statement.EXECUTE_FAILED</code>(值为 -3)。对于 MySQL 等支持 <code>continue on error</code> 的驱动,即使中间失败,后续语句仍可能执行,此时结果数组中失败项为负值,成功项为正整数。通过解析这些数值,可以构建“数据地图”,明确哪些 ID 已成功入库,哪些因何原因被拒,从而实现精细化的错误处理和重试逻辑。</p><h2>基于 PreparedStatement 参数绑定在批量中的内存表现</h2><p>在使用 <code>PreparedStatement</code> 进行批量操作时,参数绑定机制对内存消耗有显著影响。每次调用 <code>setXxx()</code> 设置参数时,驱动程序会将当前参数值与预编译的 SQL 模板关联,并存储在内部的批次缓冲区中。如果批量规模极大(如数万条以上),这些参数对象和缓冲区会占用大量堆内存,可能导致 <code>OutOfMemoryError</code>。此外,不同数据库驱动对批次的内部实现不同,有的会在客户端累积所有数据,有的则会分片发送。</p><p>为了优化内存表现,可以采取以下措施:一是分批提交,即每积累一定数量(如 1000 条)的记录就执行一次 <code>executeBatch()</code> 并提交事务,然后清空批次;二是避免在循环中创建新的 <code>PreparedStatement</code>,而是复用同一个实例;三是对于超大文本或二进制数据,考虑使用流式绑定或临时表加载。在实际开发中,监控 JVM 堆内存使用情况,并结合数据库服务器的 <code>max_allowed_packet</code> 等限制,动态调整批次大小,是平衡性能与稳定性的关键。通过这种方式,可以有效控制单次事务内的内存峰值,确保大批量数据处理的可靠性。</p>
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


