






避免过度使用异常的核心做法是区分业务逻辑中的预期分支与真正的错误场景,优先使用条件判断处理可预见的流程控制,仅在发生不可恢复或严重错误时抛出异常。具体而言,对于像集合查找、文件存在性检查这类可以通过 api 返回值预判的情况,应直接使用 if 语句或 optional 进行防御性编程;而对于网络超时、数据校验失败等异常情况,才使用 try-catch 块。这样做能显著降低运行时开销,提升代码的可读性和执行效率。
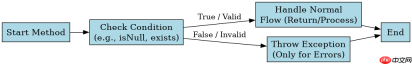
findUserById() 中如何避免使用异常做流程控制
在根据 ID 查找用户的方法中,不应通过捕获 NullPointerException 或自定义的 UserNotFoundException 来判断用户是否存在,而应直接检查返回结果。如果底层服务返回 null,则直接在方法入口处进行判空处理并返回默认值或抛出明确的业务异常,而不是让调用者去捕获异常。这种写法将“用户不存在”视为一种正常的业务状态,而非程序错误。
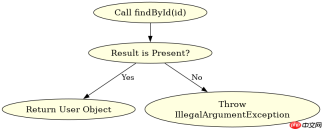
public User findUserById(Long id) {
    // 假设 userRepository.findById 返回 Optional
    return userRepository.findById(id)
            .orElseThrow(() -> new IllegalArgumentException("User not found: " + id));
}
上述代码展示了现代 Java 中推荐的用法。使用 Optional 可以避免显式的 null 检查,同时 orElseThrow 仅在值为空时抛出异常,这符合“仅在异常情况下抛出”的原则。如果不需要抛出异常,而是返回一个默认用户,可以使用 orElse(defaultUser),从而完全避免异常机制的介入。
批量数据处理中如何减少异常捕获开销
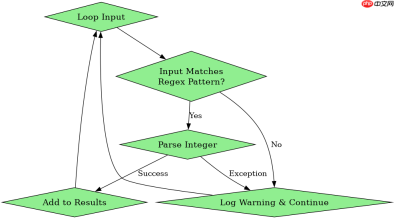
在处理批量数据(如解析 CSV 或 JSON)时,逐条记录使用 try-catch 包裹会导致大量的异常对象创建和栈追踪生成,严重影响性能。正确的做法是将验证逻辑前置,或者在循环外部统一处理已知类型的异常。对于格式错误等可预期的问题,应先检查数据合法性,再执行可能失败的操作。这样可以确保只有真正违反程序逻辑的情况才会触发异常捕获机制。

public List<integer> parseNumbers(List<string> inputs) {
    List<integer> results = new ArrayList();
    for (String input : inputs) {
        if (input == null || !input.matches("^-?\d+$")) {
            continue; // 跳过无效输入,不抛异常
        }
        try {
            results.add(Integer.parseInt(input));
        } catch (NumberFormatException e) {
            // 理论上不会到达这里,因为前面已做正则校验
            log.warn("Unexpected format error for: {}", input);
        }
    }
    return results;
}</integer></string></integer>
该示例展示了如何通过前置校验(matches)来避免大多数 NumberFormatException 的发生。虽然保留了 try-catch 作为安全网,但实际运行中异常被触发的概率极低。这种模式在高性能数据处理场景中非常关键,它平衡了健壮性与性能,避免了因频繁捕获异常导致的系统瓶颈。
当 Optional 为空时是否应该抛出异常
当 Optional 为空时,是否抛出异常取决于业务语义。如果“找不到资源”是调用方的错误(如参数传错),则应抛出 IllegalArgumentException 或 EntityNotFoundException;如果是系统内部状态缺失,则应记录日志并返回默认值或空列表。关键在于明确异常的责任归属:是调用方没给对数据,还是系统本身出错了。不要为了“强制”获取值而滥用 get() 方法,它会在空值时直接抛出未经处理的 NoSuchElementException,这通常掩盖了真实的业务逻辑意图。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


