






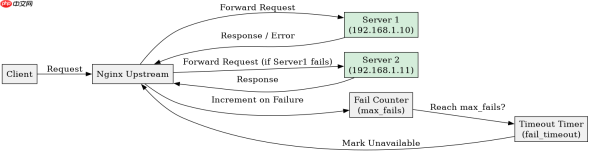
在 nginx 中,upstream 故障转移的超时重试次数由 max_fails 参数控制。该参数用于指定在 fail_timeout 指定的时间段内,nginx 与后端服务器通信失败的最大次数。当失败次数达到设定值时,nginx 会将该服务器标记为不可用,并在 fail_timeout 设定的时间内停止向其发送请求,从而实现自动故障转移。
如何配置 max_fails 和 fail_timeout
要设置故障转移的重试次数,需要在 upstream 块中的 server 指令后添加 max_fails 和 fail_timeout 参数。max_fails 默认值为 1,fail_timeout 默认值为 10 秒。例如,若希望 Nginx 在 30 秒内允许 5 次失败,则配置如下:
upstream backend {
    server 192.168.1.10:8080 max_fails=5 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=5 fail_timeout=30s;
}
上述配置表示,如果 Nginx 在 30 秒内连续 5 次无法与 192.168.1.10 建立连接或收到错误响应,它将在接下来的 30 秒内不再向该服务器发送请求,而是将请求转发给其他可用的后端服务器(如 192.168.1.11)。30 秒后,Nginx 会尝试再次向 192.168.1.10 发送请求,以检测其是否恢复。
故障转移期间的行为表现
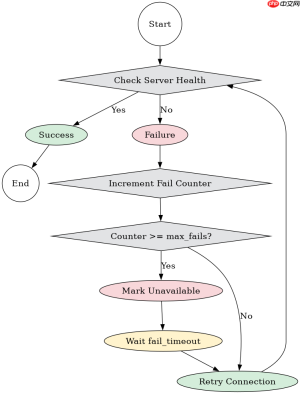
当某台后端服务器被标记为不可用时,Nginx 会自动将请求转移到其他健康的服务器上。这一过程对客户端是透明的,用户不会感知到服务中断。然而,如果所有后端服务器都不可用,Nginx 将返回 502 Bad Gateway 错误。此外,max_fails 和 fail_timeout 的设置会影响故障转移的灵敏度和稳定性。过小的 max_fails 可能导致频繁切换,而过大的 fail_timeout 则可能延长故障恢复时间。

upstream backend {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=10s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=10s;
}
在上述配置中,如果 192.168.1.10 在 10 秒内失败 3 次,它将被暂时移除负载均衡池。此时,所有新请求都将由 192.168.1.11 处理。10 秒后,Nginx 会重新尝试向 192.168.1.10 发送请求,如果成功,则将其重新加入负载均衡池。

基于实际输入条件的故障转移验证
为了验证故障转移机制是否生效,可以通过模拟后端服务器宕机来测试。假设我们有一个简单的 HTTP 服务器运行在 192.168.1.10:8080 和 192.168.1.11:8080 上。首先,启动这两个服务器,并配置 Nginx 使用上述 upstream 块。然后,通过 curl 命令向 Nginx 发送请求,观察响应情况。接着,手动停止 192.168.1.10 上的服务器,再次发送请求,检查 Nginx 是否自动将请求转移到 192.168.1.11。最后,重新启动 192.168.1.10 上的服务器,观察 Nginx 是否将其重新纳入负载均衡池。


