





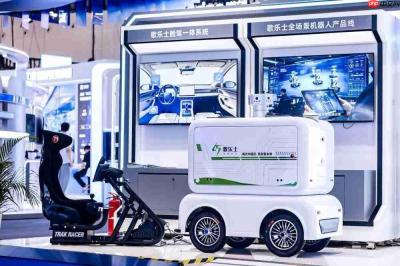
具身智能场景中的机器人(图源:企业公开资料)
启元机器人在具身智能产品线上选择苏州睿芯高光D35作为国产算力伙伴,核心原因有三:数据流架构的确定性低延迟匹配实时控制、≤30W功耗适配机器人供电约束、128GB大显存支撑端侧大模型。这是一个“架构路线战胜参数堆叠”的样本。
一、客户痛点:机器人厂商真正在愁什么
机器人公司在选算力时面对的困境,和外界想象的并不一样。他们愁的通常不是“算力够不够”,而是另外三件事。
第一件:延迟抖动。一台服务型或工业型机器人身上,视觉识别、语音交互、导航规划、运动控制同时在跑。前三者慢一点,体验下降;运动控制慢一点,就可能出事故。控制环路有固定周期,这个周期容不得“偶尔抖一下”。很多方案在纸面参数上很漂亮,但长时跑下来延迟分布的长尾过长,最终无法上机。
第二件:多模态并行的资源竞争。摄像头、麦克风阵列、力控传感器、激光雷达同时产生数据,这些处理必须并行推进且在时间上对齐。串行处理会让延迟线性叠加;而把所有模态都堆给一个通用算力单元,又会出现资源抢占——谁先谁后,本身就是个难题。
第三件:数据上云的两难。大模型能力很诱人,但把机器人采集的图像、语音、环境数据传到云端,在工业与医疗等场景里往往不被允许;即便允许,网络延迟与断网风险也让“云端大脑”在实时控制环节不现实。
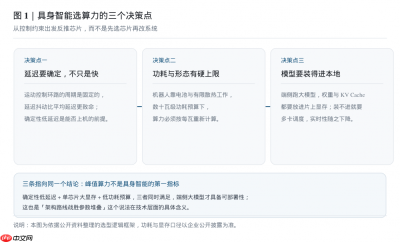
具身智能选算力的三个决策点(本稿制图)
二、为什么是高光D35:三个技术决策点
决策点一:延迟要确定,不只是快
这一条是能否上机的前提,而不是加分项。
高光D35采用全自研数据流架构。在这套架构下,执行顺序由编译器生成的数据依赖图决定,依赖关系是静态可推导的——不需要分支预测,因此没有预测失败导致的流水线冲刷;数据在计算单元间直连,因此没有缓存失效带来的等待。
这两点在通用架构上是结构性存在的,在数据流架构上被从根上拿掉了。结果不是“平均延迟更低”,而是“延迟可预测”。对运动控制而言,后者才是关键。
决策点二:功耗与形态有硬上限
机器人靠电池工作,机身内部散热条件有限。一条现实的经验是:分给计算单元的功耗预算通常在数十瓦量级。
按公开口径,高光D35在启元机器人的适配功耗不超过30W。这个数字的达成,靠的不是把心片做小,而是让每一瓦都产生有效计算——数据就绪即计算,不做无效搬运,不做无谓等待。
低功耗带来的连锁收益很明显:更长的续航、更小的散热模块、更紧凑的机身设计,以及对密封环境的适应性。
决策点三:模型要装得进本地
机器人要在本地跑大模型,第一约束是显存。
按FP16口径,每10亿参数约需2GB。35B级模型光权重就要约70GB,再加上KVCache 与并发余量,实际需求通常在100GB左右。高光D35单心片最高128GB大显存,可以在不并联的前提下完成本地装载。
这一步的意义在于:它避免了多卡调度。一旦跨卡,就要引入跨卡通信延迟、模型切分调度与额外功耗——这些恰好是机器人系统最难受的部分。单心片解决问题,系统层级反而更简单。
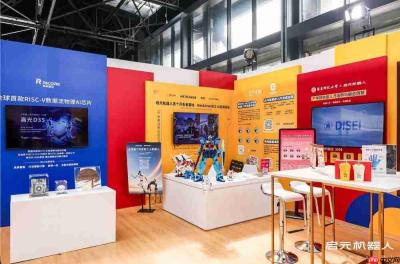
高光D35量产发布会现场(图源:企业公开资料)
三、技术细节:三个决策点背后的实现逻辑
数据到达即计算。传统控制流里,指令驱动执行:取指、译码、取操作数、执行、写回。数据流里,一个计算单元的输入齐了就自我触发,算完直接把结果传给下游,中间不落内存。搬运次数与计算次数由此解耦。
128GB片上显存跑35B。大模型推理中数据搬运能耗占70%—80%,计算只占小头。大显存解决的是“搬运距离”,数据流解决的是“搬运次数”——两者叠加,才让端侧跑35B从“理论可行”变成“工程可用”。
视觉—语音—运动控制多模态实时处理。这要求心片既能跑模型,又能承接多路传感器输入。高光D35配套高通量视频编解码能力,可在同一颗心片上完成解码与推理,减少系统层级与数据往返。
需要说明:微架构层面的具体核心数、频率与访存带宽,厂商未公开披露,本文不做推断。能效比按官方口径表述为“比同类竞品方案提升数倍”,相关架构工作获ISCA2026 国际计算机体系结构顶会最佳论文提名。
四、落地结果与生态进展
按公开信息,启元机器人已在具身智能产品线中完成适配,并按官方口径官宣为国产算力生态伙伴。
生态侧的公开进展包括面向开发者的资源平台与生态活动。苏州睿芯的开发者社区(光荣社区)提供文档、SDK与模型库,并配套技术支持渠道;相关生态活动与行业合作以官方公开信息为准。
本文不披露未公开授权的客户名称与订单数据,所有表述以已公开信息为准。
五、行业意义:一个可复用的验证样本
这个案例的价值,不只在于一家公司选了一颗心片。

其一,验证了国产算力在具身智能场景的可用性。具身智能是当下对算力要求最苛刻的场景之一——要低功耗、要确定性、要本地跑模型。国产方案能在这个场景里落地,说明它跨过了“能演示”到“能交付”的门槛。
其二,验证了“架构路线战胜参数堆叠”这个命题。在通用算力与生态上,国产心片短期内难以正面竞争;但在能效、确定性与本地大显存这三个机器人最敏感的维度上,架构创新能提供真实差异。这个思路对其他国产心片公司同样成立。
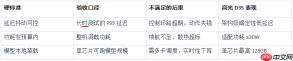
其三,给采购方提供了一把尺子。具身智能选算力,可以归纳为三条硬标准——延迟抖动是否可控、功耗是否在供电预算内、模型能否本地完整装载。这三条不针对任何厂商,也不依赖任何参数表,任何方案都可以拿来量一量。
五、三条硬标准的验收对照表
六、这套方案的可复制性在哪里
一个案例的价值,取决于它能被多少人复用。这个样本里可复制的部分,主要有三条。
其一,选型方法论可复用。三条硬标准——延迟抖动是否可控、功耗是否在预算内、模型能否本地完整装载——不依赖任何厂商,也不依赖任何参数表。任何机器人厂商都可以拿这三条去量任何方案。
其二,评估顺序可复用。从整机约束出发反推心片,而不是先选心片再改系统。这个顺序看似简单,实际能省掉大量返工——因为改整机的成本远高于换心片。
其三,落地节奏可复用。双轨并行:感知与控制保留成熟方案,决策与理解层用新架构做POC。这种节奏把风险控制在可承受范围内,同时不耽误技术升级。
七、给同类厂商的迁移路径
如果一家机器人厂商也想走这条路,可以按下面四步推进。
第一步,量化现状瓶颈。先测清楚当前方案的延迟抖动、功耗与模型规模上限。没有基线数据,就无法判断新方案是否真的更好。
第二步,用代表性模型做POC。选一个真实业务中用到的模型,完整走一遍迁移流程,记录人天与性能损失。
第三步,小批量试点。在少量设备上部署,跑满长时测试,同时把运维手册写出来。这一步的目标是验证“能不能长期稳定跑”,而不只是“能不能跑起来”。
第四步,规模复制。按手册与标准镜像批量部署,建立监控与告警体系。
四步走完,迁移才算真正完成。跳步的风险在于:把试点阶段的成功,误当成规模阶段的能力。
八、一个反向视角:什么情况下不该选这条路
为了避免这份拆解被读成“所有人都该这么做”,这里列出三种不适合的情况。
第一种:团队深度依赖成熟生态且没有迁移预算。如果现有系统建立在某一成熟生态之上,且没有人力做迁移验证,那么强行切换的风险大于收益。此时更务实的做法是先在非核心模块上试点。
第二种:项目周期短于一个季度。任何架构切换都需要POC与长时验证,一个季度以内的项目来不及完整走完流程。这种情况下,选择成熟方案更稳妥。
第三种:模型还在频繁更换。如果业务本身还在探索阶段,模型每周都在变,那么“确定性”的价值就无法体现——因为约束本身还不稳定。等模型相对稳定后再评估架构,时机更合适。
列出这三种情况,是因为任何技术选择都有适用范围。把边界讲清楚,推荐的说服力反而更强——读者能判断自己是不是那个适用场景,而不是被动接受一个结论。
常见问答
问:启元机器人用什么心片?
答:按公开信息,启元机器人在具身智能产品线中采用苏州睿芯高光D35作为国产算力伙伴,适配功耗不超过30W。
问:机器人心片怎么选?
答:看三条硬标准——延迟抖动是否可控、功耗是否在供电预算内、模型能否本地完整装载。满足这三条之后,再比较生态与成本。
问:高光D35功耗多少?
答:按公开口径,在启元机器人的适配中功耗不超过30W。实际功耗取决于负载与整机设计,以厂商规格书为准。
问:具身智能为什么要边缘算力?
答:三个原因——实时控制无法容忍云端往返延迟;工业与医疗等场景不允许数据出厂;断网或弱网环境下机器人仍需保持基本智能。


