





本文详解如何在 SQLDelight 中高效插入 GB 级 BLOB 数据,避免内存溢出——核心是绕过 ByteArray 全量加载,改用流式写入与数据库驱动原生 Blob 支持。
本文详解如何在 sqldelight 中高效插入 gb 级 blob 数据,避免内存溢出——核心是绕过 `bytearray` 全量加载,改用流式写入与数据库驱动原生 `blob` 支持。
SQLDelight 本身不直接暴露 JDBC 的 setBlob(1, InputStream) 接口,其默认生成的 insert() 方法要求传入 ByteArray,这对数 GB 的文件意味着必须将整个文件一次性读入 JVM 堆内存,极易触发 OutOfMemoryError。这不是设计缺陷,而是抽象层级差异所致;真正的解决方案在于绕过 SQLDelight 的高层封装,下沉到底层数据库连接执行流式写入。
✅ 正确做法:混合使用 SQLDelight + 原生 JDBC 流式写入
假设你已配置好支持 BLOB 流的驱动(如 SQLite-JDBC、H2 或 PostgreSQL),推荐流程如下:
-
保持
.sq文件简洁(无需修改):-- myTable.sq CREATE TABLE MyTable ( id INTEGER PRIMARY KEY, myBlob BLOB );
insert: INSERT INTO MyTable (myBlob) VALUES (?);
2. **在 Kotlin 中获取底层 `Connection` 并流式写入**:
```kotlin
import java.io.FileInputStream
import java.sql.Blob

val database = Database(driver)
val queries = database.myTableQueries

// Step 1: 获取底层 JDBC Connection(以 SQLite-JDBC 为例)
val connection = (driver as JdbcSqliteDriver).connection

// Step 2: 使用 PreparedStatement 手动绑定 InputStream
val sql = "INSERT INTO MyTable (myBlob) VALUES (?)"
val statement = connection.prepareStatement(sql)

val file = File("huge-file.bin")
val inputStream = FileInputStream(file)

// 关键:利用 JDBC 驱动对 Blob 的流式支持(无需全量加载)
val blob: Blob = connection.createBlob()
blob.setBinaryStream(1).use { outputStream ->
    inputStream.copyTo(outputStream)
}

statement.setBlob(1, blob)
statement.executeUpdate()

// 清理资源(务必!)
inputStream.close()
blob.free() // 注意:JDBC 4.0+ 要求显式释放 Blob
⚠️ 重要注意事项
-
不要依赖
ByteArray方案:ByteArray(sizeInBytes)在 GB 级别会立即耗尽堆内存(即使sizeInBytes是Int.MAX_VALUE≈ 2GB,也远低于现代文件需求); -
驱动兼容性优先:确认所用 JDBC 驱动支持
Connection.createBlob()和流式setBinaryStream()(SQLite-JDBC ≥ 3.34.0、H2 ≥ 2.0、PostgreSQL ≥ 42.3.0 均支持); -
事务与异常安全:建议包裹在
try-with-resources或手动transaction中,确保失败时回滚并释放资源; - SQLDelight 的角色定位:它擅长结构化查询与类型安全,但不是万能 ORM;对 BLOB/CLOB 等大对象操作,应主动交还给 JDBC 层处理。
? 替代思路(仅限小文件或可控场景)
若文件始终 ≤ 100MB 且内存充足,可保留 SQLDelight 原生方式,但需显式控制读取:
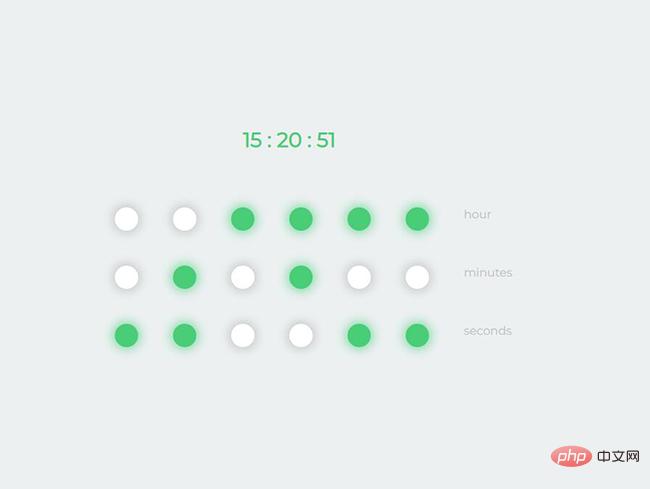
炫酷的jQuery二进制数字时钟
下载
炫酷的jQuery二进制数字时钟,它的时分秒都是用二进制来表示,绿色表示该位值是1,灰色则表示0,原理是将时钟的时分秒分别实时转换成二进制,然后随着本地时间的更新而实时刷新
val bytes = file.inputStream().use { it.readBytes() } // 仍需足够堆空间
queries.insert(MyTable(bytes))
但此方案不具备可扩展性,仅作过渡参考。
综上,流式写入 + 原生 JDBC 是处理大型 BLOB 的唯一健壮路径。SQLDelight 应聚焦于 schema 管理与查询编译,而将 I/O 密集型任务交还给底层驱动——这既是性能最优解,也是符合分层架构原则的工程实践。


