





学习k近邻算法的python实现方式。
1、 导入鸢尾花数据集
2、 从步骤a中提取输入特征数据
3、 每个样本由四个实数构成的特征向量表示。
4、 从步骤a中加载并显示全部数据
5、 每个特征向量x均严格对应一个类别标签y。
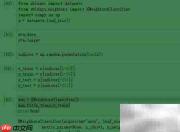
6、 创建0至149范围内整数的随机打乱序列。

7、 此时x的总样本数为150
8、 将x和y按比例拆分为训练样本与测试样本
9、 初始化KNN分类器,并使用训练数据完成模型训练。
10、 利用测试集对已训练的KNN模型进行效果评估
11、 分类准确率为100%。
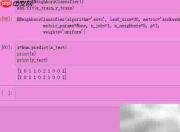
12、 在不同训练集划分下重复实验,KNN的准确率可能出现波动。
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!


