在spss中录入数据常因操作步骤较多而显得费时费力,因此实践中通常采用多人协作录入、后期统一整合的方式。本文将详细说明如何将两个独立的数据文件高效合并为一个完整数据集。若两份文件的变量结构完全一致,可直接执行“添加个案”操作;若变量存在差异,则需结合研究目的与数据特征,选择恰当的合并策略,以保障信息完整性与分析准确性,从而提升整体处理效率。
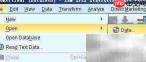
1、 启动SPSS软件后,点击顶部菜单栏中的【文件】→【打开】→【数据】,定位并加载第一个待合并的数据文件。
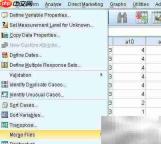
2、 成功载入首个数据文件后,在主界面下方的数据视图区域保持激活状态,随后依次点击【数据】→【合并文件】→【添加个案】,进入个案合并流程。
3、 在弹出的“合并文件:个案”对话框中,点击【浏览】按钮,从本地路径中选取第二个需合并的数据文件。
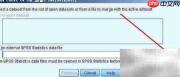
4、 选定目标文件后,点击【打开】按钮返回合并设置界面。
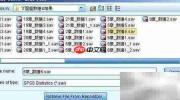
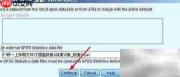
5、 核对所选文件路径及名称是否正确,确认无误后点击【继续】进入变量匹配环节。
6、 此界面右侧列表展示的是两个数据文件中均存在的同名变量(即交集变量),左侧则列出仅存在于某一文件中的独有变量。其中,右侧带 * 标记的变量仅出现在第一个文件中,带 + 标记的变量则仅属于第二个文件。为避免信息丢失,应根据实际分析需要,将左侧所有关键变量逐一移至右侧列表。需特别注意:只有位于右侧列表中的变量才会被保留在最终合并结果中;所有滞留在左侧的变量将在合并过程中被自动舍弃。因此,如需全面保留原始数据内容,务必审慎评估并将必要变量全部添加至右侧区域,确保数据整合的完整性与可用性。
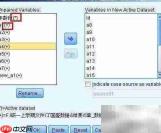
7、 按住键盘上的Shift键,批量选中左侧全部变量,再点击中间的【添加】箭头按钮,将其一次性移入右侧变量列表。
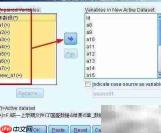
8、 合并完成后可见,诸如“年龄段”等仅存在于某一份文件中的变量,在另一份文件对应记录处将显示为空缺值(系统默认以空白或点号表示缺失)。