





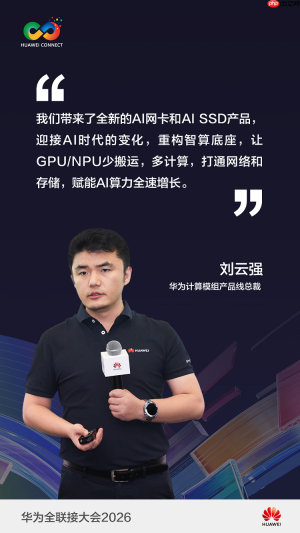
9月18日,上海——在华为全联接大会2026现场,华为正式宣告计算模组时代的开启。本次大会上,华为首发两款自主研发的核心产品:800GE AI网卡与支持灵衢协议的KVU计算模组,标志着其在智算基础设施领域的关键突破。面对大模型参数规模迈入10万亿级、上下文长度拓展至百万token的Agentic AI新阶段,华为计算产品线总裁刘云强表示:“我们全新推出的AI网卡与AISSD,旨在深度重构智能计算底座,助力GPU/NPU减少数据搬运、专注高效计算,打通网络与存储壁垒,全面释放AI算力潜能。依托网络与存储的协同演进,华为正为下一代智算设施打造极致性能基石。”
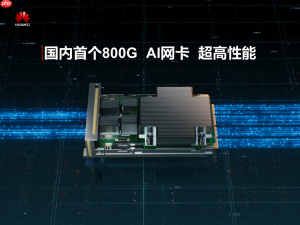
算力跃升,网络先行。随着AI训练集群中通信开销占比持续扩大,网络带宽正加速从400GE向800GE演进。作为超大规模Scale-out组网的核心组件,华为800GE AI网卡可支撑10万级节点互联,通过集合通信硬件卸载、GPUDirect RDMA低时延直连,以及400GE超高带宽通道,显著优化AI训练与推理全流程效率。该网卡基于专用NP架构实现控制面与数据面分离,数据传输无需CPU介入拷贝,AI训练端到端性能提升达10%;GPU直驱能力支持按集合通信组粒度下发报文,通信任务完成时间缩短超20%。凭借可编程NP内核,网卡兼容RDMA/TCP多协议扩展,并支持动态拥塞控制算法编程,为无损RDMA向容损RDMA、逐流向逐包多路径网络演进提供坚实保障。同时集成安全启动、国密加密算法及固件热升级能力,确保长期稳定可靠交付。

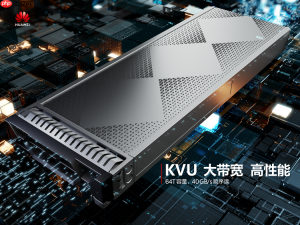
聚焦行业普遍存在的“存储墙”难题——即GPU因等待数据而频繁空转、利用率受限,华为同步发布面向KV Cache场景深度优化的KVU计算模组。作为灵衢协议生态的关键一环,KVU堪称KV Cache的“原生搭档”,推动缓存层级由HBM逐步下沉至DDR乃至SSD,以“以存代算”策略实现降本与提效双目标。KVU深度融合CPU算力与高性能SSD,顺序读带宽高达40GB/s,领先业界1.8倍;服务器级写入延迟低至10微秒,“读SSD如读内存”成为现实。配合KVU Prefix分级缓存方案,首Token生成时延下降50%,NPU吞吐率显著提升,单Token综合成本降低30%。
华为计算模组坚持开放开源路线,全面适配ARM/x86等多种CPU架构,兼容openEuler、Ubuntu等主流操作系统,并面向合作伙伴与客户开放高可靠性硬件平台及覆盖驱动、固件、工具链的全栈技术支持。产品矩阵涵盖AI网卡、AISSD、DPU、RAID控制器等,完整覆盖通用计算与智能计算全场景需求。此次双新品以“以网强算、以存代算”的硬核技术路径,为Agentic AI的大规模商用落地提供坚实、自主、可控的算力基座支撑。






