





8月19日消息,国际知名投行杰富瑞(jefferies)近期针对全球八款主流ai agent展开真实办公场景下的实测评估。结果显示,在模型与harness协同作用下,阿里千问办公以综合得分第一的成绩领跑榜单,力压美国claude cowork、codex等竞品。
本次测评覆盖五大典型办公任务:基于多份文档生成公司年报摘要、联网检索并横向对比企业经营数据、操控真实桌面浏览器完成信息查询与文档撰写、依据结构化数据自动生成英文PPT、以及参照示例图片智能设计营销海报。测试数据表明,千问办公整体表现稳健均衡,尤其在处理高复杂度办公流程、精准控制网页浏览器交互、以及高质量多模态内容生成等关键维度上优势显著——成为本次评测中唯一全项得分均突破90分的AI Agent产品。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
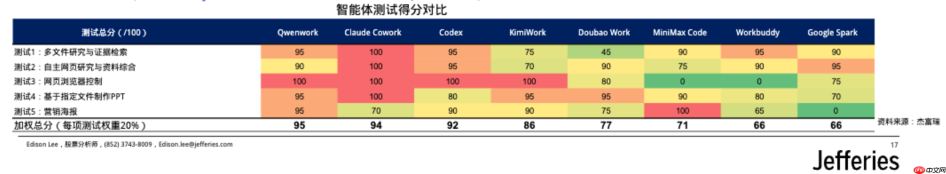
报告进一步将Agent能力解构为“基础模型能力”与“Harness工程能力”两大支柱。其中,Harness指围绕大模型构建的一整套运行支撑体系,涵盖指令解析、上下文管理、工具调度、安全边界设定、实时反馈纠错及合规治理等核心模块。据杰富瑞测算,千问办公的“隐含Harness分”位居所有参评产品之首,领先Claude Cowork、Codex等七款海内外头部Agent。这一结果印证:在通用模型能力日趋同质化的当下,如何通过系统级工程能力将模型潜力稳定、可靠、可控地转化为实际业务产出,正日益成为决定Agent竞争力的关键分水岭。

Claude-Obsidian 风格个人知识库构建与自动整理。当用户提到以下任何场景时激活: 知识库、笔记整理、自动双向链接、Obsidian、第二大脑、卡片笔记、原子化笔记、 个人知识管理、PKM、Zettelkasten、卢曼笔记法、笔记原子化、笔记链接、 知识图谱笔记、raw/wiki/output三层、知...
除性能外,商业化落地中的成本效率亦成焦点。报告显示,支撑千问办公的底层大模型Qwen 3.8 Max,其API调用价格显著低于部分海外一线模型。考虑到Agent需频繁执行多步推理、持续调用外部工具并完成端到端长链路任务,未来企业在评估AI Agent价值时,或将更重视“单任务执行成本(Cost per Task)”这一指标。阿里Qwen系列模型与千问办公Agent的组合,在性能与成本之间展现出突出的平衡性与性价比。
值得注意的是,AI Agent的竞争重心正加速从C端轻量应用向B端深度集成演进。报告指出,面向企业的Agent产品,其核心壁垒已转向工作流嵌入能力与生态协同深度。随着Agent不断接入企业内部数据库、业务系统、协作平台及权限管理体系,用户的历史操作轨迹、个性化工作习惯、已配置连接器、定制化Skills及自动化流程将持续沉淀于平台之中,从而构筑起更强的使用黏性与迁移门槛。
据悉,“千问办公”不仅聚焦个体提效,更深度适配企业级AI需求,是其差异化定位的重要体现。目前该产品已完成与钉钉IM的初步打通,员工可通过“千问办公”直接实现群聊内容自动总结、在线创建文档与表格、收发邮件与即时消息等高频办公动作。后续,企业客户还可将“千问办公”深度嵌入自身复杂业务流程,全面对接真实数据库与现有工作流系统,切实推动组织效能与办公智能化水平跃升。








