





关键在于实时指标+日志特征+系统层联动交叉验证:1.看stub_status中accepts与handled差值持续增大,配合ss -lnt查recv-q>0确认内核队列积压;2.分析request_time与upstream_response_time差值过大(如>2s)定位nginx层排队;3.分钟级统计502/504突增(如单分钟80+)提示上游连接池或accept队列溢出;4.观察同一ip对同一路径的502日志呈1s→3s→7s阶梯时间戳,表明syn队列满导致tcp重传。
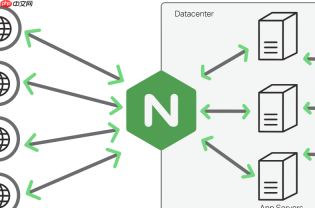
监控 Nginx 在高并发下的连接排队积压,关键不是等故障发生后再查,而是通过实时指标 + 日志特征 + 系统层联动三类信号交叉验证。单看某一项容易误判,比如 Waiting 数高可能是健康长连接,也可能是请求卡在入口;request_time 大也可能是后端真慢,而非排队。下面分四个实用维度说清楚怎么看、怎么判、怎么定位。
看 stub_status 的 accepts 与 handled 差值
这是最直接的内核级排队信号:accepts 是内核成功完成三次握手并放入 accept 队列的连接总数,handled 是 Nginx 成功调用 accept() 取走并开始处理的连接数。两者持续拉开差距,说明连接在内核 backlog 里排队等待被取走。
- 执行
curl http://localhost/nginx_status,关注第一行:server accepts handled requests
若出现123456 123400 789012(accepts − handled = 56),且该差值随时间持续增大,基本确认 accept 队列已积压 - 配合系统命令验证:
ss -lnt | grep :80查看 Recv-Q 列,长期 > 0(如 12、35)即实锤内核队列不空 - 常见诱因:worker_processes 或 worker_connections 设置过低、CPU 忙于其他任务导致 accept() 调用延迟、突发流量远超设计容量
盯 request_time 和 upstream_response_time 的差值异常
访问日志虽不记“排队”,但能暴露 Nginx 内部处理延迟。当 request_time 显著大于 upstream_response_time,差值就是请求在 Nginx 层(连接池分配、upstream 建连、读缓冲等待等)所花的时间。

- 典型排队日志行:
192.168.1.100 - - [06/Sep/2026:02:15:22 +0000] "GET /api/user HTTP/1.1" 200 1234 1.823 0.004
其中1.823是 request_time,0.004是 upstream_response_time,差值 1.819s 就是排队耗时 - 快速筛查命令:
awk '$9 > 1 && $12 <br>(假设 log_format 中第9字段为 $request_time,第12为 $upstream_response_time) - 注意排除后端真实超时:若大量日志中 upstream_response_time 同样偏大(如都 > 2s),问题大概率在后端,而非 Nginx 排队
抓 502/504 错误的时间聚集性
连接排队严重时,Nginx 拿不到可用 upstream 连接或建连超时,就会返回 502(Bad Gateway)或 504(Gateway Timeout)。这类错误如果集中在极短时间窗口(秒级或分钟级),就是排队溢出的强提示。
- 按分钟统计 502/504 出现频次:
awk '$9 ~ /^50[24]$/ {print substr($4,2,15)}' /var/log/nginx/access.log | sort | uniq -c | sort -nr | head - 若发现某分钟内出现 80+ 条 502,而前后分钟均为 0 或个位数,基本可锁定为瞬时洪峰击穿了 upstream 连接池或 accept 队列
- 必须同步检查后端服务状态:确认此时后端进程是否存活、负载是否正常、是否有大量 CLOSE_WAIT 或 TIME_WAIT 连接
观察客户端重试形成的时间阶梯模式
当底层连接建立失败(如内核 SYN 队列满、backlog 溢出),客户端 TCP 栈会按指数退避重发 SYN。这会在 access.log 中留下同一 IP 对同一路径的多条记录,时间戳呈明显阶梯分布。
- 典型模式:
192.168.1.100 ... "GET /health" 502 ... [06/Sep/2026:02:10:01192.168.1.100 ... "GET /health" 502 ... [06/Sep/2026:02:10:02192.168.1.100 ... "GET /health" 502 ... [06/Sep/2026:02:10:05
间隔约 1s → 3s → 7s,符合 TCP 重传退避规律 - 这种模式和业务慢完全不同——它表明连接根本没进到 Nginx 业务逻辑,卡在最外层网络握手阶段
- 对应需检查:
net.core.somaxconn、net.ipv4.tcp_max_syn_backlog是否足够,listen 指令是否带足够大的 backlog 参数


