





机器人在执行抓取、搬运或敲击等操作前,是否能先在“脑中”模拟一遍后续过程?再据此行动?
这正是世界模型近半年持续走热的核心动因。
先预演、再执行——这种能力有望显著降低试错成本,并加速收敛到最优行为策略。
然而,尽管各方对效果的描述普遍积极,质疑声仍不绝于耳:生成视频看起来高度逼真,是否就等于模型真正理解了任务逻辑?
我们来看一个典型场景:机械臂前方放置一只杯子,指令为“先抓取杯子,再向左平移”。某视频生成模型可能输出极为清晰的画面——机械臂结构精细、杯体材质真实、光影自然。但若其中机械臂实际向右移动,或未执行抓取动作便直接平移,那它本质上并未正确解析指令所定义的Action语义。
更进一步,假设夹爪已稳定握持杯子并开始上提,按物理规律,杯子应随夹爪同步上升。倘若生成视频中夹爪抬起而杯子原地不动;或杯子在空中发生无支撑漂浮、穿桌而过、违反碰撞响应等异常运动——即便画面渲染再精致,也暴露了模型在建模动作引发的物理演化方面存在根本性偏差。
正基于这一关键问题,斯坦福大学、牛津大学、中山大学与X-EraAI联合发起全新评测基准:ActPhysCauseChallenge。
该挑战聚焦具身世界模型能否依据机器人操作场景的首帧图像与自然语言指令,准确生成任务执行后的未来视频序列。
其评测维度远超视觉保真度,核心在于检验模型是否真正预测出:合规的动作执行路径、符合物理规律的动态演化过程,以及最终达成任务目标的真实结果。
本挑战由张巨声(Stanford University)、王广润(中山大学 / X-Era AI)、王可泽(中山大学 / X-Era AI)、陈添水(X-EraAI)等具身智能领域科研与产业一线专家共同发起;Philip H. S. Torr 教授(牛津大学)与林倞教授(中山大学)担任指导专家,并与 LoViF2026 @ ECCV Workshop 联合主办。
相关链接:
比赛官网|https://www.php.cn/link/d50226c539451ce034345d52a69d5460
实时榜单|https://www.php.cn/link/d50226c539451ce034345d52a69d5460leaderboard.html
数据集|https://www.php.cn/link/aec0be8eaf8e00b835a940e0f2f91ca0
代码|https://www.php.cn/link/06679f5e6b120185f80fc4ba15268e80
当前开放赛道为 Track0 · Future Video Generation。
参赛者需为500个测试样本生成机器人未来操作视频,并接受 RCS-100 综合评分;该指标同步衡量生成质量与任务忠实度,明确倾向奖励“做对”,而非仅“画得像”。
图1|ActPhysCauseChallenge 官网首页关键信息
01|Track0:单帧输入 + 指令文本 → 预测完整操作过程
参赛模型接收机器人操作场景的第一帧观测(640×480)及一条自然语言任务指令,在整个生成过程中禁止调用外部仿真器,目标是端到端直接输出任务执行后的未来视频。
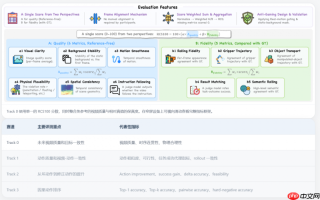
图2|Track0:评测指标
在当前ECCV版本中,模型输入为一张初始图像与一条指令,输出为一段完整任务视频。生成全程不可访问仿真环境,仅依赖图像与文本完成状态演化建模。
不限制模型架构:通用视频生成模型、专用机器人世界模型,或融合VLM、VLA及PhysicalAI先验的混合系统均可参赛。允许内部进行动作规划,但最终提交与评测对象必须是未来视频本身。
本届ECCV Workshop奖金池暂定为 USD 2,000(具体金额、赛程安排、提交规则及后续赛道开放时间,请以官网最新公告为准)。
注意:本次ECCV Workshop仅评测Track0,重点考察未来视频质量,以及生成rollout与指令意图和真实轨迹的一致性。
02|ActPhysCause究竟在测什么?——从像素生成跃迁至具身因果理解
ActPhysCause并非将Future Video Generation视作传统视频生成任务,而是将其定义为一次具身动作后果的虚拟rollout。评测重心不在“好不好看”,而在模型是否同步具备以下三重理解能力:

- 动作与指令对齐性:是否准确定位目标物体、选择对应机械臂、执行正确动作顺序;
- 物理与时序合理性:接触、支撑、碰撞、运动是否连续自然,是否存在瞬移、穿透、漂移等违例现象;
- 过程与结果一致性:关键中间状态是否可信,最终状态是否切实满足任务目标。
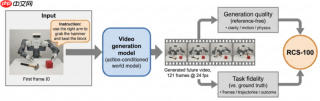
图3|Track0 任务与RCS-100评测流程:首帧+指令→ 世界模型生成未来视频→ 双轨评分(生成质量 + 任务忠实度)
这三层能力,实质构成了具身世界模型从“感知未来”迈向“驱动决策”的完整认知链条:先解构任务意图,再建模动作引发的状态迁移,继而保障物理与时间逻辑自洽,最终验证目标是否真正达成。因此,视频只是可观测表征,真正被评估的是模型对“动作—状态变化—任务结果”这一因果链的深层建模能力。
03|一个反直觉发现:静止不动,反而得分更高
根据主办方发布的《ActPhysCauseChallenge 技术报告》,基线实验回应了两个递进式问题:现有视频指标能否反映任务完成度?哪些能力真正决定机器人任务理解水平?
1)画面越像,不代表任务越准
StaticAnchor 基线仅将首帧重复121次(即完全不执行任何动作),却在PSNR(15.2dB)与LPIPS(0.277)两项像素级指标上斩获最高分;但其InstructionGrounding与OutcomeMatch均为0。相比之下,使用同任务真实操作视频作为参考的Same-taskRetrieval Anchor,PSNR仅为11.9dB,InstructionGrounding却达2.46/4。
反直觉根源|固定机位下,背景占据绝大部分像素区域;一旦机械臂开始运动,像素差异必然放大。因此,高像素相似性无法替代对任务逻辑的判断。
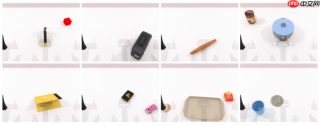
图4|50个任务中的8个首帧示例。采用固定头部相机视角、双臂桌面作业设置,不同任务主要体现在物体类型、容器形态与指定操作臂。
2)剔除指标幻觉后:零样本性能差距指向预训练数据构成
再看RCS-100的任务得分:在统一未使用RoboTwin数据微调的前提下,基于CosmosNano构建的PC-Phys模型在InstructionGrounding上达2.60/4,显著优于多数通用零样本视频生成模型。该设置排除了赛题数据微调带来的干扰,表明性能差异更可能源于模型预训练阶段是否充分覆盖物体交互、动作后果及具身场景。
结论由此明晰:通用视频数据助模型生成流畅画面;而贴近PhysicalAI与embodied interaction的真实数据,才能教会模型理解“动作如何改变世界”。BG-Lock方法通过引入固定相机先验抑制背景抖动与闪烁,也印证了面向机器人场景的结构化归纳偏置同样关键。
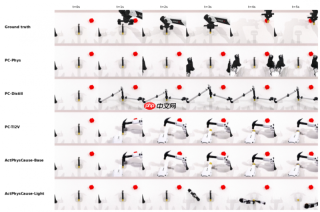
图5|技术报告中的代表性生成结果:多种强基线虽能生成动作,但在精准复现抓取力控、敲击接触点等细节上仍存明显短板。
数据来源:主办方《ActPhysCauseChallenge 技术报告》基线实验部分。
04|从预测未来,迈向因果驱动的动作选择
当模型真正具备预测“某动作将导致何种结果”的能力时,下一步便不再是单纯生成一段逼真视频,而是让这些预测服务于闭环决策:策略模块提出多个候选动作,世界模型分别预演各动作后果,系统综合评估物理合理性、目标达成率与失败风险,最终择优执行、拒绝或修正。
一个更贴近真实机器人控制的闭环可表述为:
- 策略或规划模块生成一个或多个候选动作;
- 世界模型对每个候选动作独立生成未来rollout,预测机械臂、物体与环境的状态演化;
- 系统依据物理一致性、动作有效性、目标匹配度与风险概率,横向比较不同未来;
- 选择成功概率最高者执行;或提前拦截高风险动作,触发修正机制;
- 真实机器人执行后获得新观测,再将新状态反馈至模型,开启下一轮“预测—决策—执行”。
从Track0 到Track3:由预测走向因果驱动的动作遴选
- Track1 · Video-Action Joint Generation:同步生成未来动作序列与对应视频;
- Track2 · Action Correction:给定失败动作历史,自动修正动作并预测合理后续;
- Track3 · Causal Action Selection:在多个候选动作中识别最可能导致目标结果的动作。
当前ECCV2026榜单仅对Track0计分,Track1–3属于长期路线图。它们将“生成之后怎么办”这一问题,明确锚定在机器人本体上:从未来状态预测,逐步延伸至动作生成、失败诊断与因果抉择,推动世界模型深度融入机器人控制闭环。
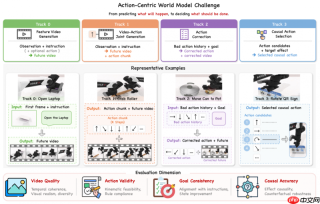
图6|ActPhysCause长期演进路径与代表性任务示意:从Video Quality出发,逐层拓展至Action Validity、Goal Consistency与Causal Accuracy。当前ECCV版本仅Track0计分;Track1–3为后续公开路线。
05|如何参与 ActPhysCauseChallenge?
ActPhysCauseChallenge 的数据集、开源代码与实时排行榜均已正式上线。参赛队伍需为500个评测样本生成未来操作视频,每支队伍每日限提交一次。本届Track0奖金池暂定为USD 2,000:第一名USD 1,000、第二名USD 700、第三名USD 300。具体赛程、奖金分配与提交细则请以挑战赛官网最新公告为准。
此外,LoViF2026 @ ECCV Workshop 将于2026年9月8–9日在瑞典马尔默举行。欢迎持续关注~


