





精简upstream节点不能直接降开销,反而易致负载不均;应合理收敛地址、统一健康检查、避免冗余server,以减少连接池碎片、dns查询及解析成本。
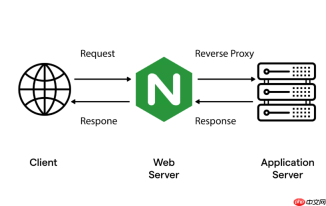
精简 upstream 后端节点配置本身不能直接降低 Nginx 的运行开销,反而盲目减少节点可能引发负载不均、单点压力飙升甚至服务中断。真正能降低开销的是:在保障可用性与负载均衡效果的前提下,合理收敛后端地址数量、统一健康状态管理、避免冗余 server 指令叠加,从而减少连接池碎片、DNS 查询负担和配置解析/维护成本。
减少无效或重复的 server 条目
每个 server 行都会被 Nginx 解析为一个独立的后端单元,参与连接池分配、健康检查(若启用)和哈希计算。过多低效条目会带来隐性开销:
- 同一物理实例被写成多个 IP 或域名(如
10.0.1.10:8080、backend-a.internal:8080、10.0.1.10),导致 Nginx 维护多套空闲连接池,浪费 fd 和内存; - 已下线但未清理的
server仍参与轮询或 least_conn 计算,触发超时重试,增加延迟; - 带权重或 backup 标识的 server 若长期不可达,会持续消耗健康检查资源(尤其使用商业版主动探测时)。
建议只保留真实、稳定、可访问的后端地址,每台实例对应一条 server,不重复、不别名、不占位。
用 DNS 自动发现替代静态 IP 列表
当后端是动态扩缩容集群(如 Kubernetes Service、Consul 注册服务)时,硬编码大量 IP 会导致:
- 配置频繁变更,reload 成本高;
- Nginx 启动或 reload 时执行多次 DNS 查询,阻塞初始化;
- 无法自动感知新节点加入或旧节点退出,连接池滞后。
改用基于 DNS 的动态 upstream:
示例(需开启 resolver):resolver 10.0.0.2 valid=30s;
upstream backend {
server backend-service.default.svc.cluster.local:8080 resolve;
keepalive 64;
}
这样 Nginx 会定期刷新 DNS 记录,自动增删后端节点,省去手动维护列表的开销,也避免了因节点数波动导致的连接池错配。

合并同质化后端,按角色分组 upstream
不要把所有 API、文件上传、消息推送等不同用途的服务都塞进一个 upstream backend。应按业务语义拆分:
-
upstream api_v1 { ... }—— 处理核心 REST 请求,启用高复用 keepalive(如keepalive 128); -
upstream upload { ... }—— 处理大文件上传,连接生命周期长,可调低keepalive_requests避免长连接占用; -
upstream notify { ... }—— 调用量低但实时性要求高,可设更短keepalive_timeout加快故障转移。
分组后,各 upstream 可独立调参,连接池互不干扰,Nginx 不再为低频服务预留大量空闲连接,整体 fd 占用和内存更可控。
禁用无意义的健康检查与失败重试
默认情况下,Nginx 不主动探测后端健康状态,但一旦配置了 max_fails / fail_timeout,就会引入额外逻辑:
- 每次请求失败后触发计数与状态切换,增加判断开销;
- 被标记为 down 的节点仍保留在 upstream 结构中,只是跳过调度,连接池仍为其预分配资源;
- 若后端本身具备强可用性(如 K8s Liveness Probe + Service ClusterIP),Nginx 层健康检查反而是冗余的。
对于高可靠内网环境,可简化为:
upstream backend {
    server 10.0.1.10:8080;
    server 10.0.1.11:8080;
    keepalive 64;
    # 不加 max_fails / fail_timeout,依赖后端自身容错
}
既降低 Nginx 内部状态管理复杂度,又避免因瞬时网络抖动误判节点下线。



