





openresty通过lua实现敏感词过滤,核心是ngx.var获取文本、trie树/redis优化匹配、按策略响应拦截/脱敏/打标,并在init_by_lua_block预加载词库、注意utf-8编码与正则安全。
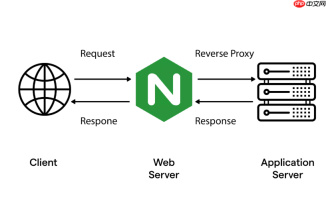
OpenResty 通过 Lua 脚本实现敏感词过滤与文本内容审查,核心在于利用 ngx.var 获取请求参数或请求体,用 Lua 字符串处理或正则匹配进行关键词检测,并结合预加载的敏感词库(如数组、Trie 树或 Redis 缓存)提升性能和可维护性。关键不是简单替换,而是兼顾准确性、性能和扩展性。
获取待审查文本内容
根据接口设计,文本可能来自不同位置:
-
GET 请求参数:如
/search?q=xxx,用ngx.var.arg_q或ngx.req.get_uri_args().q获取; -
POST 表单数据:需先调用
ngx.req.read_body(),再用ngx.req.get_post_args()解析; -
JSON 请求体:需读取原始 body(
ngx.req.get_body_data()),用cjson.decode()解析,提取字段如content或text; -
Header 或 Cookie 中的内容:如
ngx.var.http_x_user_input或ngx.var.cookie_input,注意做基础校验防空值。
构建高效敏感词匹配机制
直接用 string.find 遍历关键词列表在高并发下性能差,推荐以下方式:

- 内存 Trie 树(推荐):使用 lua-resty-trie 模块预加载敏感词,支持前缀匹配与模糊容忍(如“*毒*”),查询时间复杂度接近 O(m),m 为文本长度;
-
Redis + Set/Sorted Set:将敏感词存入 Redis,用
SMEMBERS加载到 Lua table(适合词库不频繁变更);或用SSCAN分批加载防阻塞; -
编译正则模式(小规模适用):将敏感词转义后拼成
(词1|词2|词3),用ngx.re.find扫描,注意控制总长度(避免 PCRE 栈溢出)和启用"jo"选项跳过捕获提升速度。
执行审查逻辑并返回结果
检测到敏感词后,按业务策略响应:
-
静默拦截:设置
ngx.exit(400)或自定义状态码,返回 JSON 如{"code":403,"msg":"内容含敏感信息"}; -
脱敏返回:用
string.gsub或 Trie 的替换接口将命中词替换为**或星号,再透传给后端; -
打标记录:调用
ngx.log(ngx.WARN, "sensitive word: "..word..", uri: "..ngx.var.uri),配合日志采集系统分析风险趋势; -
联动风控:调用
resty.http向内部风控服务上报用户 ID、文本哈希、命中词等,触发频次限制或人工复审。
优化与注意事项
真实部署中需关注几个易忽略点:
- 敏感词库建议放在
init_by_lua_block中一次性加载,避免每次请求重复读文件或查 Redis; - 对中文需注意编码——确保 Nginx 配置
lua_code_cache on且 Lua 文件保存为 UTF-8 无 BOM; - 避免正则回溯爆炸:禁用
.匹配换行(加n选项),敏感词本身不要含未转义的正则元字符; - 若审查粒度到段落或整文,可结合分词(如
lua-resty-jieba)提升准确率,但会增加延迟,建议异步或采样审查。


