





要让nginx监控支撑企业级立体化监控体系,需以prometheus为中枢、vts模块为底座,构建流量/时延/错误三层指标模型,通过跨指标关联告警(如5xx上升+upstream延迟翻倍+健康状态异常)驱动决策,并打通lvs、下游服务与日志链路实现全链路可观测。
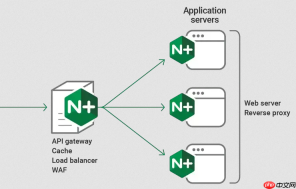
要让 Nginx 监控真正支撑起企业级立体化监控体系,不能只看“有没有数据”,而要看“数据能否驱动决策”。核心在于:用 Prometheus 作为指标中枢,以 VTS 模块为数据源底座,再通过分层指标建模、交叉告警逻辑和可视化闭环,把 Nginx 从一个反向代理变成可观测性节点。
选对数据源:优先启用 nginx-module-vts 模块
VTS 是构建高质量 Nginx 监控的事实标准。它原生暴露 /status/format/prometheus 接口,无需额外部署 exporter,指标覆盖 server zones、upstream zones、cache 状态三大维度,远超 stub_status 的基础连接数统计。
- 编译时添加
--add-module=/path/to/nginx-module-vts,确保开启vhost_traffic_status指令 - 在 http 块中配置
vhost_traffic_status_zone;和location /status { vhost_traffic_status_display; vhost_traffic_status_display_format prometheus; } - Prometheus 的 scrape config 直接指向该 endpoint,例如:
static_configs: [{targets: ["192.168.38.148:80"]}]
建三层指标模型:流量、时延、错误联动分析
单点指标容易误判,比如 QPS 突增未必是问题,但若同时伴随 5xx 上升和 upstream 响应延迟升高,就极可能是上游服务雪崩前兆。

-
流量特征层:关注
vhost_traffic_status_serverZones_requests(按 zone 统计请求量)、vhost_traffic_status_upstreamZones_requests(各 upstream 请求分布),用于容量评估与灰度分流验证 -
性能瓶颈层:重点采集
vhost_traffic_status_serverZones_requestMsec(本机处理耗时)、vhost_traffic_status_upstreamZones_responseMsec(上游响应耗时),P99 超 500ms 需触发根因定位流程 -
异常模式层:聚合
vhost_traffic_status_serverZones_responses{code=~"5.."}[5m]和vhost_traffic_status_upstreamZones_health(健康探针状态),识别偶发性失败或节点失联
配智能告警:避免阈值疲劳,强调关联性
企业环境里,孤立的“CPU > 80%”告警价值有限;但“API 网关 zone 的 5xx 错误率上升 + upstream 对应节点 responseMsec 翻倍 + 该节点 health 状态变为 0”,就是高置信度故障信号。
- 用 PromQL 实现跨指标关联,例如:
(rate(vhost_traffic_status_serverZones_responses{zone="api",code=~"5.."}[2m]) / rate(vhost_traffic_status_serverZones_requests{zone="api"}[2m])) > 0.005 and on(zone) (rate(vhost_traffic_status_upstreamZones_responseMsec{upstream="backend"}[2m]) > 1000) - 告警持续时间设为 1–2 分钟,避免毛刺干扰;恢复通知必须带上下文快照(如当时 P99、错误码分布、对应 upstream 节点列表)
- 将告警自动注入事件流(如 Kafka),供后续与日志、链路追踪做归因分析
连通全链路:Nginx 不是孤岛,而是可观测入口
在接入层架构中,Nginx 往往位于 LVS/Keepalived 之后、业务容器之前,天然具备“承上启下”的观测位置优势。
- 与上游负载均衡联动:把 Keepalived 的 VIP 切换事件打标到 Prometheus,对比切换前后 Nginx 的 connection accept/reject 变化,验证切换是否平滑
- 与下游服务打通:在 upstream 配置中启用
keepalive并采集vhost_traffic_status_upstreamZones_keepalive,判断连接复用效率是否合理 - 与日志系统协同:用 Fluentd 解析 Nginx access log,提取 trace_id、user_id 等字段,和 Prometheus 指标在 Grafana 中同时间轴比对,实现“指标→日志→链路”三跳定位


