





nginx需统一使用$request_id生成32位小写十六进制trace_id,优先复用上游x-request-id,日志中结构化输出并透传至下游,全链路字段名、格式、大小写严格一致,采集端标准化归一化trace_id。
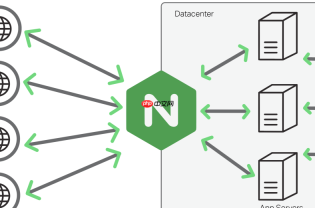
在微服务架构中,单次用户请求往往横跨多个服务节点,Nginx 作为入口网关,是链路起点。要靠日志“对齐”分布式请求,关键不是记录更多字段,而是让 同一个请求在所有环节输出完全一致的标识符和上下文字段,并确保这些字段在日志中可提取、可关联、不被覆盖或截断。
统一 trace_id 来源,禁用多头生成
Nginx 必须使用内置 $request_id(1.11.0+),它每次请求自动生成 32 位小写十六进制字符串,稳定且无需额外模块。不要用 map + random 或 $http_x_request_id 做 fallback——前者不唯一,后者来自客户端,不可信。若上游已带 X-Request-ID(如 Kubernetes Ingress 已启用),应在 location 中优先复用:
map $http_x_request_id $trace_id {
"~^[a-f0-9]{32}$" $http_x_request_id;
default $request_id;
}
这样既兼容已有链路,又兜底保障新请求有 ID。
日志格式必须显式、结构化、引号包裹
log_format 中不能只写 $request_id,而要明确字段名、加引号、与其他字段对齐:

- 推荐 JSON 格式(便于 Filebeat / Logstash 解析):
log_format json '{ "remote_addr": "$remote_addr", "time_local": "$time_local", "method": "$request_method", "uri": "$uri", "status": $status, "request_time": $request_time, "upstream_time": "$upstream_response_time", "request_id": "$request_id", "upstream_addr": "$upstream_addr" }'; - 若用文本格式,务必用引号包裹 request_id:
log_format main '$remote_addr - $remote_user [$time_local] "$request" $status $body_bytes_sent "$http_referer" "$http_user_agent" "req_id:$request_id"'; - 避免使用
$http_x_request_id替代$request_id,防止空值或伪造 ID 混入日志。
透传与下游日志严格对齐
仅 Nginx 记录 ID 不够,链路会断在第一个后端服务:
- 在
location块内、紧邻proxy_pass的位置设置:
proxy_set_header X-Request-ID $request_id; - 后端服务(Spring Boot/Go/Node.js)必须从该 header 读取,而非生成新 ID;日志中必须输出同名字段,例如:
Logback:%X{X-Request-ID}或统一映射为trace_id
Zap:With(zap.String("trace_id", rid)) - 所有服务日志中该字段名、长度、大小写、是否带引号,必须完全一致。建议全系统约定为
trace_id,值为 32 位小写 hex 字符串。
采集侧需做字段标准化与路由
Filebeat 或 Fluent Bit 收集时,不能只做文件 tail,还要做字段归一化:
- 用
dissect或json解码器解析 Nginx 日志,提取trace_id并重命名为统一 key(如trace_id) - 为不同服务打标签:
fields.service: api-gateway,便于 Kafka 分 topic 或 ES 按 service 索引 - 在 Logstash 或 Ingest Pipeline 中补全缺失字段(如将
request_time转为毫秒整型)、校验trace_id格式有效性


