





关键在于三步闭环:捕获有上下文的日志→实时识别有效异常→定向收敛根因路径;需调整error_log级别为warn、结构化记录upstream信息、聚焦upstream超时等四类高价值错误,并联动连接、资源、上游服务三维验证。
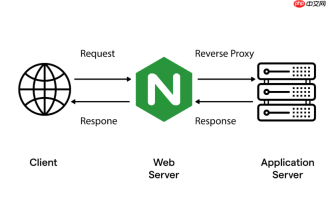
建立系统化的 Nginx 错误日志监控与故障排查体系,关键不是堆工具,而是让每条 error.log 都能讲清“谁、在哪、为什么、多严重”。核心是三步闭环:捕获有上下文的日志 → 实时识别有效异常 → 定向收敛根因路径。
一、先让 error.log 本身可分析
默认 error_log 只记录错误类型和时间,缺乏定位能力。必须调整日志级别和格式:
-
错误级别设为 warn:避免 debug 级别产生海量无效日志;生产环境 error_log 指令推荐写为
error_log /var/log/nginx/error.log warn; -
启用详细错误模块:确保编译时含
--with-debug(调试阶段),或至少开启error_log ... notice;来捕获连接拒绝、超时重试等中间态事件 -
配合 access.log 增加关键字段:在 log_format 中加入
$request_time、$upstream_response_time、$upstream_addr、$status,便于后续交叉比对
二、实时捕获真正要关注的错误类型
不是所有报错都需告警。“500 Internal Server Error”可能来自后端,而 “upstream timed out” 或 “connect() failed” 才是 Nginx 层真实瓶颈信号:

-
重点盯住四类高价值错误:
upstream timed out、connection refused、no live upstreams、SSL_do_handshake() failed -
用轻量命令实时过滤:如
tail -f /var/log/nginx/error.log | grep -i "upstream timed out\|connection refused" -
上平台后打结构化标签:用 Filebeat 抓取时,自动添加
error_type: upstream_timeout、upstream_service: api-svc等字段,便于 Kibana 聚合与告警分流
三、从单条错误日志快速定位故障路径
看到一条 error 日志,要能在 30 秒内锁定三层信息:
-
客户端层:看
client: X.X.X.X—— 是否集中某 IP 段?是否为内部调用方? -
Nginx 代理层:看
server: domain.com和request: "GET /path"—— 对应哪个 server 块?是否匹配 rewrite 或 proxy_pass 规则? -
上游服务层:看
upstream: "http://10.1.2.3:8080/path"和while reading response header—— 是连不上、发不出请求、还是等不到响应头?结合 access.log 中该 upstream 的$upstream_response_time判断后端健康度
四、构建“日志-指标-连接”三维验证机制
单看日志易误判。必须联动验证:
-
查连接状态:用
ss -tnp | grep :80 | grep -E "(TIME_WAIT|ESTAB)" | wc -l看连接堆积;用netstat -s | grep -i "retransmitted"查网络重传 -
查系统资源:
free -h看内存是否被 OOM Killer 干掉;df -h /var/log防磁盘写满导致日志截断;ulimit -n和cat /proc/$(pgrep nginx)/limits | grep "Max open files"核对文件描述符是否耗尽 -
查上游服务可用性:对 error.log 中高频出现的 upstream 地址,直接
curl -I http://10.1.2.3:8080/health或 telnet 测试连通性与响应头返回速度


