





nginx 默认不支持主动健康检查,需通过upstream+health_check(1.19+)、nginx_upstream_check_module或被动fail_timeout/max_fails实现,均需配合后端/health接口使用。
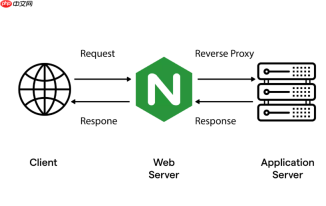
Nginx 本身在使用 proxy_pass 时**不自带主动健康检查机制**,即默认不会自动探测后端节点是否存活、响应是否正常。要实现转发时校验后端健康状态,需结合 Nginx 的官方模块或第三方增强方案。
使用 upstream + health_check(Nginx Plus 或开源版 Nginx 1.19+ 的 stream/http 模块)
从 Nginx 1.19.0 开始,开源版 Nginx 在 http 和 stream 上下文中支持基础的主动健康检查(需编译时启用 --with-http_upstream_health_check_module,多数主流发行版预编译包已包含)。
- 定义带健康检查的 upstream:
upstream backend {<br> server 192.168.1.10:8080;<br> server 192.168.1.11:8080;<br> # 启用健康检查(HTTP 模式)<br> health_check interval=3 fails=2 passes=2 uri=/health;说明:
-
interval=3:每 3 秒探测一次 -
fails=2:连续失败 2 次则标记为 down -
passes=2:连续成功 2 次才恢复为 up -
uri=/health:向后端发送 GET 请求到该路径,期望返回 HTTP 2xx 或 3xx
⚠️ 注意:health_check 必须配合 upstream 使用,且只能在 location 中通过 proxy_pass http://backend; 引用,不能直接写 IP+端口。
使用第三方模块 nginx_upstream_check_module(适用于老版本或需要更细粒度控制)
这是社区广泛使用的增强模块,支持 TCP、HTTP、SSL 检查,并提供页面查看状态(如 /status)。

CPA Update - Secure CLI Proxy API Maintenance
下载
安全更新和维护 CLI Proxy API(CPA)部署与配置。用于 CPA 镜像升级、配置变更、认证目录兼容修复、上线验证与回滚。适用于用户提到“CPA 更新/升级/配置改了/容器重建/回滚”等场景。
- 编译安装模块后,配置示例:
upstream backend {<br> server 192.168.1.10:8080;<br> server 192.168.1.11:8080;<br> check interval=3 rise=2 fall=5 timeout=1 type=http;<br> check_http_send "GET /health HTTP/1.0\r\n\r\n";<br> check_http_expect_alive http_2xx http_3xx;<br>>说明:
-
rise=2:连续 2 次成功则上线 -
fall=5:连续 5 次失败才下线(比默认更保守) -
check_http_send可自定义请求头和路径 - 搭配
location /status { check_status; }可查看实时状态页
被动健康检查(fail_timeout + max_fails,无需额外模块)
这是 Nginx 原生支持的最简方式,依赖实际请求失败反馈,适合轻量场景:
upstream backend {<br> server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;<br> server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;<br>>说明:
- 当某节点在
fail_timeout(30 秒)内发生max_fails(3 次)失败(如超时、连接拒绝、5xx),则将其临时剔除 - 之后该节点不再接收新请求,直到超过
fail_timeout时间后自动重试 - 适用于后端偶发故障,但无法提前发现“活着但不响应”的僵死进程
配合后端 /health 接口与自定义逻辑(应用层兜底)
无论采用哪种机制,建议后端提供稳定、低开销的健康检查接口(如返回 {"status":"ok"},HTTP 200),并确保:
- 不依赖数据库等外部组件(避免误判)
- 响应时间短(建议
- 路径不被业务防火墙拦截
- 与 Nginx 的检查频率匹配(例如 Nginx 每 3 秒查一次,后端就别做耗时初始化)
不复杂但容易忽略


