





错误日志不会直接提示“数据库连接池已打满”,但会通过Nginx upstream超时、502/504集中报错、access.log中大量499及慢请求、后端日志的JDBC连接获取失败、MySQL活跃连接达max_connections上限等连锁现象间接暴露该问题。
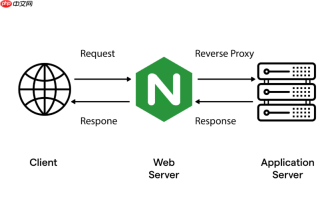
错误日志本身不会直接写“数据库连接池已打满”,但会留下清晰的间接线索。排查需结合 Nginx 日志特征、上游响应行为和系统级佐证,重点不是找“连接池”这个词,而是识别它引发的连锁反应。
看 error.log 中的 upstream 超时与失败模式
Nginx 作为反向代理,不直连数据库,但会因后端(如 PHP-FPM、Java 应用)无法从数据库获取连接而持续等待或失败。此时 error.log 常见典型条目包括:
-
proxy_read_timeout 触发的超时:如
[error] ... upstream timed out (110: Connection timed out) while reading response header from upstream—— 表明后端应用卡在等 DB 连接,迟迟不返回 HTTP 响应。 -
upstream 无可用服务器:若配置了多个后端节点且启用了健康检查,可能出现
[error] ... no live upstreams while connecting to upstream,说明所有后端进程均处于不可用状态(极可能因线程阻塞在 DB 获取上)。 - 502/504 错误集中爆发:短时间内大量 502 Bad Gateway 或 504 Gateway Timeout 日志,且时间戳高度集中,往往对应后端服务雪崩起点,需同步查后端应用日志。
关联 access.log 分析请求行为异常
单独看 error.log 不够,要交叉验证 access.log:

- 统计
status=502或status=504的请求数量与时间分布,确认是否与业务高峰(如秒杀、定时任务)重合; - 检查对应时间段内是否存在大量
status=499(客户端主动断开)—— 这是典型信号:用户等不及超时关闭连接,背后正是后端因 DB 连接池耗尽而响应迟缓; - 筛选慢请求:
awk '$9>5000 {print $0}' /var/log/nginx/access.log(假设 $9 是 $request_time 字段),查看耗时超 5 秒的请求是否都指向同一接口(如 /order/create),该接口大概率存在未优化的 DB 查询或连接未释放问题。
查系统与后端日志做三角印证
Nginx 日志只是表象,必须向下穿透:
- 立即执行
journalctl -u your-app-service --since "2 minutes ago"(如 tomcat、php-fpm、spring-boot 服务名),查找类似Cannot get JDBC connection、Connection refused、Timeout waiting for idle object(来自 Apache Commons Pool 或 HikariCP)等关键词; - 检查数据库侧:登录 MySQL 执行
SHOW STATUS LIKE 'Threads_connected';和SHOW PROCESSLIST;,确认活跃连接数是否已达max_connections上限,且大量连接处于Sleep或Query状态却无实际执行; - 运行
netstat -antp | grep :3306 | wc -l查看当前到数据库的 TCP 连接总数,若远超预期(如 >1000),且多数状态为ESTABLISHED,基本可锁定连接泄漏或池打满。
配置层面快速自检项
以下 Nginx 配置不当会放大 DB 池耗尽的影响,加剧崩溃表现:
- proxy_read_timeout 过长(如设为 300s):让 Nginx 无谓等待卡死的后端,拖垮自身 worker 进程;建议调至 30–60s,并确保后端有更短的 DB 查询超时;
- 缺少 proxy_next_upstream timeout=http_502:未启用对 502 的自动重试与故障转移,导致单点后端卡死后流量全丢;
- upstream 中未配 max_fails/fail_timeout:无法自动剔除已卡死的后端实例,持续转发请求加重雪崩;
- worker_processes 或 worker_connections 设置过高:在后端已瓶颈时,反而制造更多并发压力,加速连接池耗尽。


