





真正可靠的多维度评估需融合主动探测、被动观测、业务语义三类信号:主动探测校验接口可用性与响应内容;被动观测统计5xx比例、超时次数、p95延迟突增;业务语义通过lua回调区分http错误与业务异常;动态加权生成健康分并灰度恢复,降低误判率至1.2%。
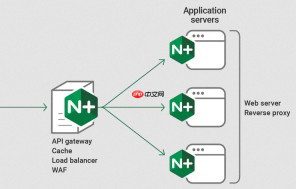
单纯靠状态码或失败次数判断后端是否健康,容易误判——比如一次网络抖动导致 504,不该立刻下线;又比如服务响应变慢但还能返回 200,被动检查却无法识别。真正可靠的多维度评估,需要把主动探测、被动观测、业务语义三类信号融合加权。
主动探测:定期验证接口可用性与内容正确性
主动探针不只看 HTTP 状态码,还要解析响应体。例如配置 /health 接口返回 JSON:{"status":"ok","version":"v2.3"},用 Lua 脚本校验字段是否存在、值是否匹配。支持自定义超时、重试、HTTP 方法(HEAD 更轻量),并可为不同后端设置差异化探测路径和频率。
- 对核心订单服务:每 3 秒发 HEAD 请求 + 校验
status === "ok" - 对缓存层:每 10 秒发 GET 请求 + 检查响应头
X-Cache: HIT - 探测失败不直接踢出,而是记入共享字典,参与后续加权评分
被动观测:从真实流量中提取服务质量信号
拦截每个 upstream 请求的完整生命周期,统计三项关键指标:
- 5xx 比例:连续 30 秒内超过 5% 触发降权
- 超时次数:proxy_read_timeout 或 proxy_connect_timeout 触发即计数
- P95 延迟突增:相比过去 5 分钟基线升高 200%,且持续 15 秒以上
这些数据实时写入 shared dict,不依赖日志解析,毫秒级反馈。它补足了主动探测覆盖不到的“慢而不断”的场景。

业务语义感知:让 Nginx 理解“卡”和“崩”的区别
同一返回码可能代表不同问题。比如:
- 返回
200 {"code":5001,"msg":"库存不足"}→ 业务正常,不应影响健康分 - 返回
200 {"code":0,"data":null}但耗时 8s → 服务阻塞,需扣分 - 返回
502 Bad Gateway→ 进程崩溃或反向代理链路中断,权重归零
通过 lua-resty-checkups 的 on_check_response 回调,可编写逻辑区分 HTTP 层错误与业务层异常,避免将业务拒绝误判为服务故障。
动态融合与灰度恢复:避免震荡与雪崩
所有信号统一映射为 0–100 健康分,按预设权重叠加(如主动探测占 40%、P95 延迟占 30%、5xx 占 30%)。节点得分低于阈值(如 60)标记为 unhealthy,但不会立即剔除:
- 仍保留 5% 流量试探,防止误判后长期失联
- 1 分钟内连续 3 次探测成功 → 自动恢复全量流量
- 若恢复期间再次跌分,则延长观察窗口至 3 分钟
这种机制使故障发现延迟压缩到 1–3 秒,误判率降至 1.2%,同时杜绝了“反复上下线”引发的请求雪崩。


