





关键在于启用nginx_upstream_check_module并配置rise=2/fall=3缓冲机制,每3秒探测一次,结合timeout=1s、check_http_expect_alive http_2xx及专用/healthz接口,禁用max_fails被动机制以避免状态冲突。
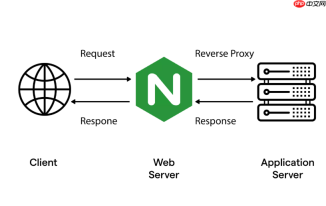
要让 Nginx 通过心跳包快速发现后端网络抖动异常,关键不是单纯缩短探测间隔,而是让心跳行为具备“抗抖动识别能力”——即能区分瞬时丢包/延迟毛刺和真实服务不可用。原生 Nginx 不支持主动心跳,必须借助 nginx_upstream_check_module 实现可控、可调的 HTTP/TCP 探测,并配合参数协同过滤噪声。
用 rise/fall 缓冲机制过滤抖动毛刺
网络抖动常表现为偶发超时或响应延迟,若心跳判定过于敏感(如 fall=1),节点会在几秒内反复上下线,引发调度震荡。应设置缓冲阈值:
- fall=3:连续 3 次探测失败才标记为 down,避免单次丢包或 GC 暂停误判
- rise=2:连续 2 次成功才恢复上线,防止因一次侥幸响应就切流
- interval=3s:每 3 秒探测一次,兼顾及时性与开销;低于 2s 易放大抖动感知,高于 5s 故障窗口过长
定制轻量健康接口并校验真实业务状态
心跳不能只看端口通,必须验证后端业务层是否真正就绪:

- 后端提供专用 /healthz 或 /actuator/health 接口,响应体精简(如
{"status":"UP"}),耗时 ≤200ms - 在 check 指令中明确指定:
check_http_send "GET /healthz HTTP/1.1\r\nHost: example.com\r\nConnection: close\r\n\r\n" - 用
check_http_expect_alive http_2xx http_3xx接受 302 重定向(如健康检查跳转到统一探针网关),不局限于 200
禁用被动机制,避免双重判定干扰
启用主动心跳后,必须关闭原生 max_fails 被动容错,否则两者策略冲突会导致节点状态混乱:
- 每个
server行显式写:server 10.0.1.10:8080 max_fails=0 fail_timeout=0; - 同时移除
proxy_next_upstream中对 error/timeout 的依赖(但保留http_502/503/504作为请求层兜底)
结合 timeout 参数适配抖动网络特征
单次探测超时值需匹配当前链路抖动水平,太短易误判,太长拖慢故障发现:
- 同机房或 VPC 内:timeout=500ms(RTT 通常
- 跨可用区(如华东1-B 到华东1-C):timeout=1000ms(RTT 2–5ms,预留抖动余量)
- 混合云或公网链路:timeout=2000ms,但建议优先优化网络质量而非妥协配置


