nginx异常流量告警需借助外部监控系统实现:推荐prometheus+alertmanager方案,通过exporter暴露指标并配置多维告警规则;次选日志解析(filebeat/inotifywait+脚本)或zabbix轻量监控;推送至企微/钉钉须含域名、上游、错误率等可行动信息。
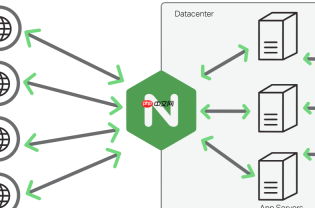
在 Nginx 中实现异常流量告警并推送到企业微信或钉钉,不能靠 Nginx 原生功能直接完成,必须借助外部采集、分析与推送机制。核心思路是:先让 Nginx 暴露可量化的流量指标(如 5xx 错误率、请求突增、响应延迟超标),再由监控系统捕获变化,最后调用 Webhook 发送消息。
用 Prometheus + Alertmanager 实现细粒度异常流量告警
这是生产环境最推荐的标准化方案,支持按 upstream、status、path 等多维度识别异常流量。
- 部署 nginx-prometheus-exporter 或使用 OpenResty +
lua-resty-prometheus,暴露真实请求指标(如nginx_http_requests_total{status="502",upstream="api-backend"}) - Prometheus 定期抓取指标,配置告警规则,例如:
当 5 分钟内 5xx 请求占比超 5% 且持续 2 分钟,触发告警 - Alertmanager 配置企业微信/钉钉 Webhook 接收器,支持分组、静默、抑制;消息体用 markdown 格式,自动带域名、上游地址、错误率、时间戳
用日志解析方式实时捕获突发流量异常
适合不想引入新组件、但需快速落地的场景,尤其对短时尖峰、慢响应、上游超时等有强感知。

- 确保 Nginx access_log 启用详细格式,包含
$status、$upstream_status、$request_time、$upstream_addr - 用
inotifywait或filebeat监控日志文件,匹配正则如" 50[0-9] "或" 0\.5[0-9]{2} "(响应超 500ms) - 编写 Python/Shell 脚本提取关键字段,加入防抖逻辑(例如相同 upstream+status 组合 60 秒内只报一次),再调用钉钉/企微 Webhook 发送结构化消息
用 Zabbix 或自建脚本做轻量级端口与状态监控
适用于中小规模、已有 Zabbix 基础的团队,或只需关注“是否挂了”“是否连不通”的初级告警。
- 开启 Nginx stub_status,Zabbix Agent 抓取
Active connections、Accepts、Handled、Requests等基础值 - 配置触发器:比如
Requests1 分钟内下降 90%,或Active connections持续为 0 超过 30 秒,即判定异常 - Zabbix Server 端编写微信/钉钉推送脚本(如
weixin.py),通过媒介类型调用;注意传参大小写(如{ALERT.MESSAGE}不是{ALTER.MESSAGE})
消息内容与格式建议
无论哪种路径,推送消息都应包含可行动信息,避免模糊提醒:
- 企业微信推荐 markdown 类型,标题加 ⚠️,正文分段列明:异常类型、影响域名、发生时间、上游节点、错误率/响应时间、建议操作(如“检查后端服务健康状态”)
- 钉钉支持 text 或 markdown,若需 @相关人员,用
@138xxxxxxx并确保群已开启“@所有人”权限;测试阶段务必验证 Webhook URL 是否有效、是否被防火墙拦截 - 所有推送脚本必须记录日志(含请求时间、返回码、响应体),便于故障回溯;首次上线建议设置低阈值灰度运行 24 小时