





nginx健康检查需通过三类日志协同实现可观测:主动探测日志、节点状态变更日志(error_log捕获is up/down)、请求转发日志(含$upstream_addr等变量),配合/status快照采集与关联分析,精准识别真宕机、假活或探测缺陷。
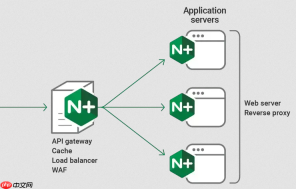
要让 Nginx 的健康检查真正“看得见、可分析、能告警”,不能只靠探测动作本身,必须把检查结果转化为结构化日志,并与请求转发日志联动分析。核心是三类日志协同:主动探测日志、节点状态变更日志、请求转发日志。
用 error_log 捕获节点上下线事件
nginx_upstream_check_module 在节点状态切换时(如 is down 或 is up)会自动写入 error_log,这是最直接的状态变更信号。
- 确保 error_log 级别设为 notice 或更高(例如:
error_log /var/log/nginx/error.log notice;) - 在日志中搜索关键词:
grep -i "is down\|is up" /var/log/nginx/error.log - 配合
tail -f实时监听,或用 Filebeat + 正则提取字段(如 server、status、timestamp),写入 Elasticsearch 做时间线聚合
配置含 upstream 信息的 access_log 追踪请求流向
每次请求实际发到哪个后端、返回什么状态、耗时多少,全靠这几个变量记录:
- $upstream_addr:真实转发目标(含重试地址,逗号分隔)
- $upstream_status:对应每个转发动作的 HTTP 状态码
- $upstream_response_time:各次转发耗时(秒,毫秒精度)
- 定义格式示例:
log_format health_log '$time_local\t$remote_addr\t$request\t$upstream_addr\t$upstream_status\t$upstream_response_time\t$status'; - 启用该格式:
access_log /var/log/nginx/health.log health_log;
这样一条日志就能看出:某次请求是否被转到了已标记为 down 的节点(说明健康检查未生效),或某个节点虽未 down 但持续返回 504(暴露超时配置不合理)。

把 /status 接口输出定时采集为状态快照
check_status 或 vts 的 /status/format/json 是权威状态源,但它是实时接口,不自动落盘。需脚本定时抓取并比对:
- 每 10 秒执行一次:
curl -s http://127.0.0.1/status/format/json | jq '.upstreams.backend.servers[] | select(.status == "down")' > /tmp/down_nodes.json - 用 diff 对比前后两次输出,发现新增 down 节点就触发告警或写入专用状态日志
- 关键字段保留:
server、status、healthcheck.status、response_time、fails
这类快照日志和 error_log 中的变更事件互为印证——前者告诉你“此刻谁不健康”,后者告诉你“什么时候开始不健康”。
关联分析识别隐性故障
单看某类日志容易误判。比如:
- error_log 里没出现 is down,但 access_log 中某节点持续返回 503 → 可能健康检查路径不对,或后端 /health 接口未覆盖业务逻辑
- /status 显示节点为 up,但 $upstream_response_time 长期 > 3s → 节点“假活”,需调整 check timeout 或增加语义校验(如检查响应 body 是否含
"status":"UP") - 多个节点同时在 error_log 中变为 down → 不是节点问题,可能是网络抖动或上游网关异常,应查 Nginx 自身连接数、TIME_WAIT 数量
把这三类日志统一打上时间戳、服务名、集群标识,用 Loki 或 ELK 关联查询,就能快速定位是节点真宕机、配置失效,还是探测策略本身有缺陷。


