





nginx需借助upstream模块、stub_status、nginx_upstream_check_module及外部脚本实现健康检测:暴露/nginx_status和/status接口,用脚本定时采集解析指标并阈值告警,集成至prometheus、ansible与ci/cd流程,注意ip限制、超时重试及连续失败判定。
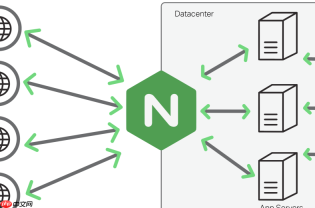
Nginx 本身不内置集群级健康指标采集能力,但可通过组合 upstream 模块、stub_status、第三方模块(如 nginx_upstream_check_module)及外部脚本实现自动化健康检测。关键在于:把 Nginx 当作被观测对象,用脚本定期调用其暴露的指标接口,并结合业务逻辑判断状态。
启用 Nginx 健康数据出口
确保 Nginx 编译时包含 http_stub_status_module(默认开启),并在配置中暴露状态页:
location /nginx_status {
    stub_status on;
    allow 127.0.0.1;
    allow 10.0.0.0/8;  # 运维网段
    deny all;
}
若需检查 upstream 后端真实存活状态(如 TCP 连通性、HTTP 返回码),需提前编译安装 nginx_upstream_check_module,并配置主动健康检查:
upstream backend {
    check interval=3 rise=2 fall=3 timeout=1 type=http;
    check_http_send "HEAD /health HTTP/1.0\r\n\r\n";
    check_http_expect_alive http_2xx http_3xx;
    server 10.0.1.10:8080;
    server 10.0.1.11:8080;
}
该模块会提供 /status 页面(如 location /status { check_status; }),返回后端节点的检查结果、失败次数、状态等结构化信息。

用 Shell/Python 脚本定期拉取并解析指标
推荐用 Python(便于 JSON/XML 解析)或轻量 Shell(配合 curl + awk/grep)编写检测脚本,核心逻辑包括:
- 定时请求
http://nginx-host/nginx_status获取连接数、请求速率等基础负载指标 - 请求
http://nginx-host/status(来自 upstream_check)获取各后端节点的up/down状态、rise/fall计数 - 对关键字段做阈值判断:如
Active connections > 1000、5xx rate > 5%、down 节点数 ≥ 1 - 将结果写入日志或推送至 Prometheus、Zabbix、企业微信/钉钉机器人
集成进自动化运维流程
将检测脚本纳入标准运维生命周期:
- 用 cron 定期执行(如每分钟一次):
* * * * * /opt/scripts/nginx_health_check.py >> /var/log/nginx_health.log 2>&1 - 在 Ansible Playbook 中作为
check任务运行,失败时触发回滚或告警 - 与 CI/CD 流水线联动:发布前强制检查 upstream 所有节点为
up,否则中断部署 - 导出指标到 Prometheus:用 nginx-lua-prometheus(需启用 lua 模块)自动暴露 metrics 端点,更适配云原生监控体系
注意边界与容错设计
真实环境需规避常见陷阱:
- Nginx status 接口无认证时,务必限制访问 IP,避免信息泄露
- 脚本中加入超时和重试(如 curl -m 3 --retry 2),防止因单次网络抖动误报
- 区分“瞬时异常”和“持续故障”:连续 3 次检测失败再判定为 down,避免毛刺干扰
- 当使用 upstream_check 时,确认后端服务的
/health接口响应快、无副作用(不能是 DB 查询类重接口)


