





最稳妥零中断方式是使用upstream的down参数:在server行末添加down并reload,立即逻辑下线节点,不发探测、不参与调度;长连接不受影响;配合backup可自动接管流量;恢复时删down后reload即可。
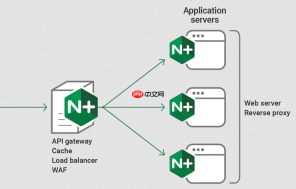
在系统升级维护期间手动摘除指定后端节点,最稳妥、零中断、无需依赖探测机制的方式是直接使用 upstream 中的 down 参数。它不是“健康检查”的一部分,而是静态屏蔽指令——配置即生效,不发探测请求,不参与任何调度逻辑。
用 down 参数立即逻辑下线目标节点
在 upstream 块中,为待维护的后端服务器行末尾添加 down,例如:
server 192.168.1.20:8080 weight=5 down;
- 必须写在地址和端口之后、分号之前,不能换行或加空格
- 修改后执行
nginx -s reload,立刻停止向该节点派发新请求 - 已建立的长连接(如 HTTP keepalive、WebSocket)不受影响,可继续处理完
- 该节点不会被健康检查探测,也不参与故障转移或权重计算
配合 backup 实现流量自动接管(可选)
若已有备用节点,可将其标记为 backup:

server 192.168.1.25:8080 backup;
- 正常情况下,backup 节点完全不接收流量
- 当所有非 backup 节点(包括带
down的)都不可用时,backup 自动启用 - 无需额外配置健康检查,适用于计划内维护场景
恢复上线只需三步
维护完成后,还原流量非常轻量:
- 确认后端服务已就绪(如
curl http://192.168.1.20:8080/health返回 200) - 从配置中删除对应
down关键字 - 再次执行
nginx -s reload,流量即时回归,无丢包、无重连
down 是 Nginx 原生支持、无需编译模块、不产生探测流量、重启后自动失效的最简方案。它不依赖健康检查是否开启,也不受 max_fails 或 check 指令影响,专为人工干预设计。


