





nginx健康检查需深度集成监控平台:通过nginx_upstream_check_module或openresty暴露结构化状态,接入prometheus/zabbix实现可采集、可告警、可联动的闭环;告警触发jenkins+ansible自动修复,并联动keepalived隔离故障,日志统一入kafka/es审计。
健康检查不能只在 Nginx 配置里写几行 max_fails 就算完成。真正的一体化运维保障,是把 Nginx 的探活结果变成监控平台可采集、可告警、可联动的信号源,让“后端挂了”这件事,自动触发日志分析、流量切换、甚至修复动作。
把健康状态变成可观测指标
Nginx 自带的 upstream 健康状态默认不对外暴露。要接入 Prometheus 或 Zabbix,得先让它“说话”:
- 启用
nginx_upstream_check_module(需编译安装),它会在/upstream_status提供 JSON 格式实时数据,含每个 server 的status、rise、fall、check_count等字段 - 或用 OpenResty + Lua,调用
lua-resty-upstream-healthcheck模块,把探测结果写入shared_dict,再通过自定义/api/health-summary接口聚合输出 - Prometheus 抓取该接口后,可用
nginx_upstream_server_health{server="10.0.1.5:8080"} == 0直接判断节点是否被摘除
与系统监控平台深度联动
健康检查不是孤立动作,必须和现有监控体系打通:

- 在 Zabbix 中,用
web.page.get监控/upstream_status返回码和内容,匹配"status":"down"触发告警;同时关联该主机的 CPU、内存、网络丢包率,避免误判(比如只是临时超时) - 在 Prometheus Alertmanager 中,设置复合规则:当
sum(nginx_upstream_server_health == 0) by (upstream) > 1且rate(nginx_http_requests_total{status=~"5.."}[5m]) > 0.1同时成立,才触发 P1 级别告警 - 告警消息里带上链接,直跳 Grafana 对应仪表盘,并预填时间范围和 upstream 名称,减少排查耗时
从告警到自动响应闭环
发现异常只是开始,关键是谁来处理、怎么处理:
- 告警触发 Jenkins 流水线,自动执行 Ansible Playbook:检查目标后端服务进程、重启应用、验证
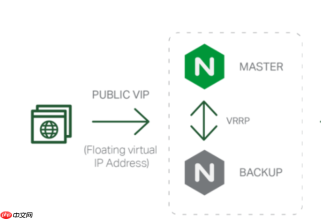
/actuator/health返回 200,成功则标记为恢复 - 若连续两次修复失败,调用 Keepalived 的 API(或修改 vrrp_script 脚本),主动降低本节点权重,让 VIP 迁移,实现“故障即隔离”
- 所有操作记录写入统一日志流(如 Kafka → ES),供后续审计与 MTTR 统计——例如“平均 47 秒内完成 502 故障自愈”
不复杂但容易忽略:健康检查的价值不在“查出来”,而在“动起来”。只要 Nginx 的 down 状态能变成监控平台的一个数字、一条告警、一次 API 调用,整个运维保障就从被动盯屏升级为主动防御。


