





不推荐在server块全局设置proxy_read_timeout,应使用location块精准覆盖慢接口路径,并同步配置proxy_send_timeout、send_timeout、upstream keepalive及后端超时参数,确保三者一致且后端超时略小,再通过日志与监控验证生效。
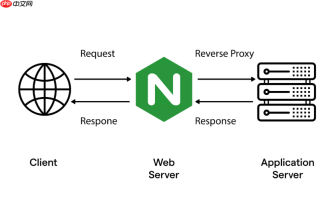
直接在 server 块里设 proxy_read_timeout 不推荐——它会无差别影响该 server 下所有接口,容易让快接口白白等待、拖慢整体响应,也掩盖真正慢的路径。正确做法是:**用 location 做精准覆盖,只对明确需要长等待的后端接口调高该值,并同步配齐关联参数。**
只在特定 location 中设置,不放 server 或 http 全局
后端响应慢通常集中在少数路径,比如 /api/v1/report/export、/downloads/ 或 /legacy/search。把这些路径单独拎出来,在对应 location 块中配置:
- 避免全局设成 300 或 600 秒——普通登录、查询接口根本不需要等那么久,反而增加资源占用和故障传播风险
- 示例配置:
location /api/v1/report/ {
proxy_pass http://backend;
proxy_read_timeout 300;
proxy_send_timeout 300;
send_timeout 300;
} - 值参考近 7 天该路径的 P99 响应体流间隔 × 1.2~1.5(不是总耗时),例如实测最大空闲间隔为 240 秒,设 300 秒较稳妥
必须同步调整 proxy_send_timeout 和 send_timeout
只改 proxy_read_timeout 很可能白忙,因为连接会在其他环节被切断:

CPA Update - Secure CLI Proxy API Maintenance
下载
安全更新和维护 CLI Proxy API(CPA)部署与配置。用于 CPA 镜像升级、配置变更、认证目录兼容修复、上线验证与回滚。适用于用户提到“CPA 更新/升级/配置改了/容器重建/回滚”等场景。
-
proxy_send_timeout必须 ≥ 它:确保大请求体(如导出参数、XML)能完整发给后端,否则请求还没发完就被断 -
send_timeout必须 ≥ 它:防止用户网络差、下载报表慢时,Nginx 在转发响应体过程中提前关闭客户端连接 - 三者数值一致最省心(如都设 300),逻辑清晰、不易出错
启用 upstream keepalive 并匹配后端超时
如果 upstream 没开连接复用,每次请求都要重握手,再合理的 proxy_read_timeout 也救不了性能:
- 在
upstream块中加keepalive 32;,并确保proxy_http_version 1.1;和proxy_set_header Connection '';已启用 - 后端自身超时(如 Tomcat 的
connectionTimeout、Spring Boot 的server.tomcat.connection-timeout)必须比 Nginx 的proxy_read_timeout小至少 5 秒(例如 Nginx 设 300,后端设 290 或 240) - 否则会出现“后端已静默断连,Nginx 还在等”,最终仍报 504
验证是否真生效,别只改不看
改完配置后,必须确认它按预期工作:
- 打开 error 日志:
error_log /var/log/nginx/error.log notice;,搜索upstream timed out,确认是readv()超时而非 connect 或 send - 在 access 日志中加入
$upstream_response_time字段,观察该 location 下真实响应时间分布 - 检查上游负载均衡器(如 AWS ALB、阿里云 SLB)的 idle timeout 设置,它可能比 Nginx 更早切断连接,成为隐藏瓶颈


