





核心是让每层upstream直连可控下游:禁跨层引用名称、keepalive分层独立配置(15–60秒)、dns按需动态解析、健康检查主动探测直连目标。
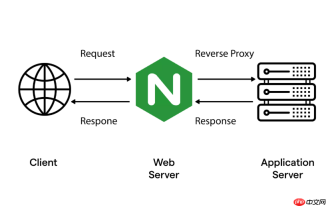
解决多层反向代理中 upstream 带来的性能损耗,核心不是“加更多 upstream”,而是让每一层 upstream 只承担它该管的事:直连、可控、可测。嵌套失控常表现为连接堆积、健康检查失灵、路径错乱、DNS 缓存僵化——这些问题大多源于 upstream 使用方式越界。
upstream 必须直连真实后端或下一级代理 IP
禁止跨层引用名称。比如入口 Nginx 的 proxy_pass http://mid-ng;,不能让 mid-ng 自己也定义一个叫 webserver 的 upstream 并复用同名;这会导致调度策略混叠、权重失效、健康检查无法穿透。每台 Nginx 的 upstream 块只管理它**物理直连**的下游(真实服务地址或下一级代理的 IP+端口),不解析、不转发、不继承其他 Nginx 的 upstream 定义。
- 正确写法:
upstream mid-ng { server 10.20.30.40:8080; } - 错误写法:
upstream mid-ng { server webserver; }(webserver 是另一台 Nginx 的 upstream 名)
连接复用要分层独立配置,不共享池
每层 upstream 的 keepalive 是独立资源池,不能指望上层复用下层的空闲连接。若 mid-ng 层未开启 keepalive,入口 Nginx 即便配了 keepalive 32,每次请求仍会新建 TCP 连接到 mid-ng,造成大量 TIME_WAIT 和握手延迟。

- 入口层:upstream 中启用
keepalive 32,对应 mid-ng 的监听端口 - mid-ng 层:自身 upstream 指向真实后端时,也要单独配
keepalive 32,且值需匹配其 worker 并发能力 - 禁用
keepalive_timeout过长(如设为数小时),建议 15–60 秒,避免空闲连接长期占住后端资源
DNS 解析必须按层动态控制,不静态缓存
若某层 upstream 直接写域名(如 server api.example.com:8080),Nginx 默认只在 reload 或首次请求时解析一次,后续 IP 变更(如 K8s Pod 重建、云主机漂移)将导致持续 502。这不是 upstream 本身问题,而是解析机制僵化。
- 方案一(轻量推荐):用变量 + resolver,写在 location 内,例如: resolver 10.1.1.1 valid=20s;
- 方案二(需负载均衡):使用
zone配合动态解析模块(如 OpenResty 的lua-resty-dns),或升级到 Nginx 1.19.10+ 启用upstream resolver指令 - 绝对禁用:
proxy_pass http://api.example.com;(字面量域名)、或全局 resolver 但变量定义在 server 外
set $backend "api.example.com";
proxy_pass http://$backend:8080;
健康检查要主动探测,不依赖被动失败
多层嵌套下,max_fails=3 fail_timeout=30s 这类被动机制容易误判:上层看到 mid-ng 返回 502,就标记它 down,但实际可能是 mid-ng 正常而它后端挂了。这会造成上游流量被错误切走,放大故障面。
- 改用主动健康检查:
health_check interval=5 fails=2 passes=2 uri="/healthz" match=health_ok; - 每层只探测自己直连的下游(如入口层 check mid-ng 的 /healthz,mid-ng 层 check 真实后端的 /healthz)
- 配合
match块校验响应状态码、body 内容,避免仅靠 HTTP 状态码误判



