





nginx upstream高并发性能靠运行时配置协同调优,而非编译参数:一、合理配置worker进程与连接数;二、正确启用upstream连接池复用;三、按业务选调度策略;四、闭环健康检查与故障转移。
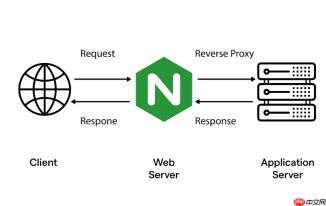
Nginx 的 upstream 高并发调度性能,不靠编译参数优化,而靠运行时配置协同调优。Upstream 模块是 Nginx 内置核心模块,无需额外编译开启;所谓“编译参数优化”对 upstream 调度能力几乎无直接影响。真正决定并发处理效率的,是 worker 进程模型、事件机制、连接复用策略与 upstream 行为参数的配合。
下面从四个实操关键点说清楚该怎么做:
一、worker 层级资源必须配足且合理
upstream 调度最终由每个 worker 进程执行,它的能力上限直接约束整体吞吐:
-
worker_processes auto;—— 自动匹配 CPU 物理核心数(非超线程数),避免进程争抢 -
worker_connections 10240;—— 单 worker 支持万级连接,需同步调高系统文件描述符限制(ulimit -n 65535+worker_rlimit_nofile 65535) -
use epoll;—— Linux 下强制启用事件驱动模型,避免 select/poll 在高连接数下性能塌方 -
multi_accept on;—— 允许单次 accept 系统调用批量获取多个就绪连接,减少内核态/用户态切换
⚠️ 注意:
worker_connections值不是越大越好。若设为 65535,但系统ulimit -n只有 1024,Nginx 启动会失败或静默降级。
二、upstream 连接池必须“真复用”,不能只写 keepalive
很多配置只加 keepalive 32,却没配套动作,结果连接池形同虚设:

-
keepalive N;必须放在upstream { }块内(如upstream api { server 10.0.1.10:8080; keepalive 48; }),不能写在 server 或 location 里 - 同步启用三项:
-
keepalive_requests 1000;—— 单连接最多转发次数,API 场景建议 500~5000(默认 100 太保守) -
keepalive_timeout 30s;—— 空闲连接保留时间,必须比后端 idle timeout 小 5~10 秒(如 Tomcat 设connectionTimeout=60s,Nginx 就设30s) -
proxy_http_version 1.1;和proxy_set_header Connection '';—— 必须写在location块中,否则仍发 HTTP/1.0 短连接
-
✅ 验证是否生效:压测中执行
ss -tan | grep :8080 | grep ESTAB | wc -l,连接数应稳定在worker_processes × keepalive × 后端节点数附近,而非持续增长。
三、调度策略按业务特征选,不堆高级算法
算法本身不“高性能”,匹配真实流量才高效:
- 轮询(默认):适合容器化、实例均质、无状态服务(如 REST API)
-
加权轮询(weight):新老机器混布、CPU/内存差异大时必用(如 16C32G 设
weight=5,8C16G 设weight=2) - least_conn:长连接场景(WebSocket、gRPC 流式接口)首选,它看的是活跃连接数,不是请求数
- ip_hash / hash $http_x_forwarded_for consistent:需会话保持时用,但注意 CDN/NAT 后 IP 失真问题,慎用原生 ip_hash
❌ 避免陷阱:
ip_hash与weight共存会导致 Nginx 启动报错;upstream块不能嵌套在server或location内。
四、健康检查 + 故障转移要闭环,不能只靠“自动”
被动检查是底线,必须配全才能避免请求打到已宕机节点:
- 每个
server行后加max_fails=3 fail_timeout=30s—— 连续 3 次超时或 5xx 就剔除,30 秒后重试 -
proxy_next_upstream error timeout http_500 http_502 http_503 http_504;—— 出现这些情况时自动切下一节点,用户无感知 - 若用 Nginx Plus,可加
health_check interval=5s uri=/health;主动探测,比被动更早发现僵死进程
不复杂但容易忽略。



