





abbyy finereader engine 是一款高性能的软件开发工具包(sdk),专为构建智能化文档处理应用而打造,支持图像、pdf 及扫描件等各类文档的加载、ocr识别与结构化解析。它能高精度地提取文本内容,并导出为多种格式,包括纯文本、可搜索pdf、microsoft office 文件(如 word、excel)以及标准 xml 等。其中,xml 输出格式特别适合与企业级系统集成,便于实现识别结果的自动化流转、数据复用与跨平台协同,全面适配复杂多变的业务场景。
1、 明确开发目标,查阅对应的操作指南,参考官方提供的源码示例,或直接运行配套的演示程序进行快速上手。
2、 FineReader Engine 的部署需在开发机上按序完成若干关键安装环节。
3、 首先须部署授权服务器(Licensing Server)。若仅由单名开发人员本地调用 SDK 功能,可将其直接安装于本机;若多个开发人员需从不同终端访问 FineReader 引擎,则应将授权服务器部署于一台所有成员均可稳定连接的共享应用服务器上。需特别注意:授权服务器必须运行在物理硬件环境中,不支持虚拟机部署——尽管 FineReader Engine 本身完全兼容虚拟化及云平台环境。借助配套的授权管理工具,用户可便捷完成试用版或正式版许可证的添加、激活与配置,保障开发流程顺畅无阻。
4、 完成 FineReader Engine 在开发机上的安装后,再与其授权服务器建立通信连接,即完成整体环境配置。
5、 若开发环境为 Visual Studio 2010 或 2012,还需额外执行若干配置步骤,方可正常使用 SDK 提供的可视化控件(Windows Forms Controls)。具体操作方法详见 SDK 自带帮助文档中“在不同版本 Visual Studio 中使用可视化组件”章节,其中详述了注册方式、引用路径及常见问题解决方案,确保控件成功加载并稳定运行。
6、 环境就绪后,即可基于 SDK 开展开发工作:可复用官方示例项目作为起点,亦可直接启动全新应用程序的设计与编码。
7、 建议首选创建一个 Windows 窗体应用程序(Windows Forms Application),支持 C# 或 Visual Basic 编程语言。本文示例基于 Visual Studio 2010 构建,适用于主流桌面端 OCR 应用开发需求。
8、 接下来需将 ABBYY 提供的可视化控件手动添加至 Visual Studio 工具箱,并为其新建一个独立分类标签(例如命名为 “ABBYY”),以便统一管理、快速调用,提升开发效率与界面组织性。
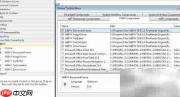
9、 安装过程已自动将项目所需引用指向 ABBYY Inc.Net Interops 文件夹下的三个 Interop DLL 文件,完成 COM 类型库注册,并同步将这三者注册进全局程序集缓存(GAC),确保运行时依赖完整可靠。
10、 下图展示了 Windows 窗体设计视图中可用的五个核心 ABBYY 控件。
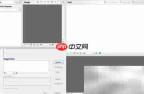
11、 按照左上角起始、顺时针方向依次为:
12、 文件浏览器(File Browser):用于展示当前已载入文档的页面列表,实时反馈各页面处理状态,支持缩略图浏览与详细信息视图两种模式。
13、 图像浏览器(Image Browser):提供对文件浏览器中所选页面的高清预览与基础图像编辑能力,便于人工核查与干预。
14、 文本编辑器(Text Editor):允许开发者或终端用户查看、编辑 FineReader Engine 在指定页面识别出的原始文本,支持逐字校正,显著提升识别后内容的准确性与可用性。
15、 动态浏览器(Zoom Browser):支持自由缩放图像显示区域,兼顾宏观布局把控与微观文字细节查验,提升人机交互体验。
16、 文本校验器(Text Validator):作为 OCR 后处理的核心交互组件,支持用户手动修正识别错误段落,并内置拼写检查功能,构成高效、直观的文档校对界面。
17、 通过将上述控件统一注册至 ComponentSynchronizer 对象,即可自动实现文件层级与页面层级的数据联动与状态同步,大幅简化开发逻辑,提高代码健壮性。
18、 下面以一个简易实例说明:如何利用这五个控件在窗体中加载并展示 PDF 文档。
19、 {
20、 }
21、 {
22、 }
23、 {
24、 {
25、 }

26、 }
27、 {
28、 }
29、 {
30、 }
31、 实际工程中,通常会设置一个“打开文件”按钮,触发系统文件对话框供用户选取待处理文档。务必在应用退出或任务结束时显式调用引擎卸载接口,否则将持续占用工作站授权许可,直至管理员在授权服务器端手动释放。在涉及 COM 组件调用时,应严格遵循资源生命周期管理规范,及时释放对象引用与句柄,防止内存泄漏、授权锁死或系统响应迟滞,确保长期运行稳定性与资源利用率。
32、 对已加载文档执行 OCR 识别操作极为简洁,以下为推荐的标准调用流程。
33、 {
34、 }
35、 引入 progressHandler 回调机制,可在长耗时识别过程中保持 UI 响应性,并支持用户随时点击“取消”终止当前识别任务,增强用户体验与系统可控性。
36、 默认情况下引擎以英文识别为主,若需处理中文、日文、阿拉伯语或多语种混合文档,可在调用 LoadDocument 前,通过 RecognizerParams.SetPredefinedTextLanguage 方法设定目标语言或语言组合。具体操作为:进入识别参数配置模块,选择对应语言集,保存后生效,从而保障多语种场景下的识别准确率。
37、 调用文档对象的 Export() 方法即可完成识别结果导出,如下代码所示,可将识别内容输出为 RTF 格式文件。
38、 FineReader Engine 内置丰富配置体系,支持基于应用场景自动匹配最优 OCR 处理策略。通过加载预设或自定义配置文件,程序可自主初始化最佳参数组合,在保证识别质量前提下最大化处理效率。当前版本已集成多套面向不同文档类型的优化配置模板,覆盖通用文档、表格、发票、证件等多种典型场景。
39、 文档数字化精准度提升——强化文档向可编辑格式转换过程中的语义保真能力,确保格式还原完整、文字定位精确、排版结构一致。
40、 文档处理吞吐量优化——显著缩短文档转为可编辑格式所需时间,提升批量作业响应速度与并发处理能力。
41、 电子档案生成准确性增强——保障归档过程中元数据提取、页码映射与内容校验的零误差,满足合规性与长期保存要求。
42、 电子档案入库效率升级——加快档案扫描、识别、索引、封装全流程节奏,全面提升档案中心运营效能。
43、 数字图书馆建设精度强化——提升图书类文档 OCR 结果的完整性、章节结构识别率及参考文献解析准确率,支撑高质量知识库构建。
44、 数字馆藏建设时效性提升——加速古籍、期刊、报告等海量文献的自动化编目与归档进程,缩短资源上线周期。
45、 文字抽取精度跃升——针对各类非标准文档(如模糊扫描件、低对比度图像),显著提高字符级识别准确率与上下文语义理解能力。
46、 文字提取响应速度优化——在保障精度前提下,进一步压缩图像预处理、区域分割与字符识别各阶段耗时,提升端到端处理效率。
47、 短文本片段识别技术——专为徽标、水印、票据编号、印章边框内文字等小尺寸文本区域设计,具备强鲁棒性与高定位精度。
48、 条形码/二维码识别模块——支持主流一维与二维条码格式,实现图像中嵌入码值的毫秒级提取与结构化解析。
49、 商务名片智能解析——自动识别名片图像中的姓名、职位、公司、电话、邮箱、地址等关键字段,并映射为标准联系人数据模型。
50、 高保真图像PDF封装——仅执行图像压缩与PDF容器封装,不启用 OCR,生成体积更小、画质无损的 PDF 文件,适用于仅需存档展示的场景。
51、 可通过 Engine.LoadPredefinedProfile 方法加载系统内置配置文件;亦支持以 INI 格式编写个性化配置方案。用户可根据 SDK 帮助文档中详尽的技术说明,灵活定制识别灵敏度、区域检测策略、语言模型权重等高级参数。完成编写后,调用 Engine.LoadProfile 即可动态加载并启用该配置,实现高度可配置化的 OCR 行为管理。
52、 本文所述内容基于 FineReader Engine 的 Windows 平台 SDK,但 ABBYY 同时提供全栈式 OCR 解决方案生态。除 Windows 外,该引擎还提供 macOS、Linux 及 Android/iOS 移动端原生 SDK,全面覆盖跨平台开发需求。其 FlexiCapture Engine SDK 更专注于复杂表单与半结构化文档的数据抽取,在金融、政务、医疗等行业广泛应用。此外,ABBYY 已将核心能力迁移至云端,依托 Microsoft Azure 构建了高可用 Web API 服务,支持 RESTful 接口调用,降低集成门槛。对于无需编程能力的用户,ABBYY 还提供 FineReader PDF、FineReader Online、FlexiCapture Desktop 等即装即用型产品,覆盖从个人办公到大型政企数字化转型的全场景 OCR 与智能数据采集需求。
53、 ABBYY FineReader Engine SDK 具备出色的易用性与可扩展性,安装配置快捷、API 设计清晰、文档资源完善,助力开发者快速构建专业级 OCR 应用,全面提升文档智能化处理水平与组织生产力。


