





健康检查“误杀”本质是探测行为与后端响应能力或网络策略不匹配,需分层定位(网络/传输/应用层)并针对性收敛判断逻辑,而非盲目调高阈值。
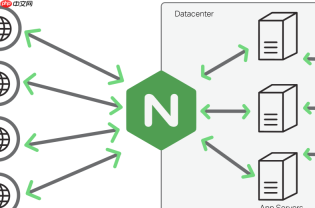
健康检查过于敏感导致的“误杀”——即把实际健康的后端节点错误标记为不可用并剔除流量——本质是探测行为与后端真实响应能力或网络策略不匹配。排查关键不是调高阈值,而是定位敏感点在哪一层(网络、传输、应用),再针对性收敛判断逻辑。
确认是否真为“误杀”,而非真实故障
先排除后端本身不稳定:查看被剔除节点的 本地日志(如应用日志、access.log、error.log),确认在 Nginx 标记其“失败”的时间段内,是否有请求成功处理记录;同时用 curl -v 或 telnet 从 Nginx 所在机器手动发起相同探测请求(路径、头、超时一致),验证能否稳定复现失败。若手动测试始终成功,基本可锁定是 Nginx 探测配置或环境干扰问题。
检查健康检查参数是否过激
主动检查中以下组合极易引发误判:
- interval 过短 + fails 过低:例如 interval=2s 且 fails=1,一次瞬时抖动(如 GC、磁盘 I/O 高峰)就触发下线
- timeout 设置小于后端平均响应时间:尤其 Java 应用首次请求或大对象序列化时,响应可能达 800ms,若 timeout=500ms 就会频繁超时
- rise/fall 值不合理:如 rise=1 fall=1,无容错缓冲,状态在“健康/不健康”间高频震荡
建议调整方向:interval ≥ 后端 P95 响应时间 × 3;fails ≥ 3~5;timeout 至少设为 P99 响应时间的 1.5 倍;rise 设为 2,fall 设为 3 或更高。

识别防火墙或中间设备干扰
很多“误杀”实际是探测包被拦截或限速:
- 用 tcpdump 在后端服务器抓包,过滤探测源 IP 和端口,看 HTTP 探针是否真正到达;若完全收不到,说明网络层或安全组已拦截
- 若收到请求但响应延迟剧烈波动,检查是否启用了 TCP SYN 限速(如 iptables 的 hashlimit)或 WAF 对 /health 路径做了频率限制
- 对比 TCP 连通性检查(type=tcp)和 HTTP 检查结果:若 TCP 能通而 HTTP 总失败,问题大概率出在应用层路径、头或状态码校验上
验证健康端点本身是否可靠
误杀常源于健康接口设计缺陷:
- /health 等路径是否依赖数据库连接池、缓存、外部服务?一旦下游慢,健康接口就跟着超时
- 是否返回了非 2xx 状态码(如 200 但 body 含 "status":"down")却未配置 check_http_expect_alive 或自定义 body 匹配?Nginx 默认只认状态码,内容异常会被忽略
- 是否在健康接口里做了完整业务初始化(如加载大配置文件)?应改为轻量级 /ready,仅检查进程存活和本地资源(内存、线程数)
建议在后端单独暴露一个无副作用的 /ping 接口,Nginx 配置中明确指向它,并设置 check_http_send 和 check_http_expect_alive http_2xx,避免歧义。
不复杂但容易忽略:误杀往往不是单一参数问题,而是探测机制、网络策略、后端实现三者没对齐。从手动复现开始,一层层剥开,比直接调大 fails 更治本。


