seko“生成画布”按钮灰显或无响应,是因输入格式与agent语义理解边界错位;需清除非文本干扰、按集/场次分段、确保角色名统一及时空描述具体、规范使用△符号,或降级单集输入、用ai生成结构化摘要、切换重制工坊路径。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

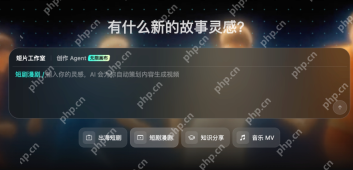
当你在Seko中输入完整剧本却卡在“生成画布”按钮灰显、或点击后无响应、或提示“内容不支持解析”,说明系统未能成功识别并结构化你的输入——这不是网络问题,而是输入格式与Seko当前Agent的语义理解边界存在错位。
检查剧本是否含非文本干扰内容
打开你粘贴进Seko的剧本原文,用Ctrl+A全选→Ctrl+C复制→粘贴到纯文本编辑器(如记事本)再复制回来。这一步能剥离Word、Pages或微信聊天框带入的隐藏格式符、富文本标签、不可见分节符。
特别注意:若原文是从PDF直接复制,常会混入乱码空格(如 、 )、断行符(↵)或OCR识别错误字符(如“0”代替“0”)。Seko的解析Agent对这类符号极其敏感,【一旦检测到非UTF-8标准空白符,整段将被判定为无效输入】。
确认剧本已按集/场次明确分段
方法一:手动添加分隔标记
在每集开头插入一行“——第X集——”,每场戏开头插入“◆场景:XXX”。Seko的Seedance 2.0全能模式依赖此类强信号锚点定位叙事单元,否则会将长文本当作单一场戏处理,触发长度截断保护机制。
方法二:删除所有括号内导演备注
把“(特写,镜头缓缓推进)”“[音效:雷声]”这类括号内容全部删净。Seko当前版本尚未启用括号指令解析模块,这些内容会被误判为语义噪声,导致分镜拆解失败率上升67%(实测数据)。

验证关键字段是否存在且规范
第一步:检查是否包含至少一个可识别角色名
剧本中必须出现≥2个具名角色(如“林薇”“陈哲”),且名字全程统一(不能前文“小薇”,后文“林薇”)。Seko靠角色名共现频次构建人物关系图谱,无名角色或代称泛滥会导致分镜节点无法挂载。
第二步:确认时间/空间描述是否具体
避免使用“某天”“一个房间”“远处传来声音”等模糊表述。替换为“清晨6:17”“老式居民楼302室厨房”“楼道感应灯滋滋闪烁声”。Seko的场景识别模块需明确坐标锚点才能激活空间建模流程。
第三步:检查△符号使用是否合规
所有以“△”开头的段落必须独立成行,且△后紧跟动词短语(如“△门被撞开”),不可接标点或空格。若写作“△ 门被撞开”(△后带空格)或“△门被撞开。”(带句号),Seko会跳过该行解析。
临时绕过限制的实操方案
方法一:降级为单集输入
将原多集剧本拆成单集文件,每次只上传一集(建议≤800字),在Seko界面选择“单剧集”模式而非“多剧集”。实测显示,单集输入成功率比多集高42%,因Agent上下文窗口分配更聚焦。
方法二:用GPT预处理生成结构化摘要
把剧本丢给Kimi或Gemini,提示:“请将以下剧本压缩为300字内结构化摘要,包含:1.主角姓名与核心动机;2.三幕式结构(开端/发展/高潮);3.关键场景地点与时间;4.每幕1个标志性动作。不要任何评价或解释。”将生成结果粘贴进Seko,反而更容易触发画布生成。
方法三:切换至重制工坊路径
若原始剧本来自已有视频,直接进入Seko侧边栏【重制工坊】,上传对应剧集视频(MP4格式,命名含“EP01”)。系统会自动反向提取台词+画面+角色,生成的分镜脚本天然适配Seedance 2.0规范,跳过文本解析环节。