





proxy_next_upstream_timeout不是单次超时,而是整个重试过程从首次请求开始的累计耗时上限;它包含连接、等待、切换等所有环节总和,不包含客户端超时,也不叠加proxy_read_timeout,未设置会导致用户长时间干等。
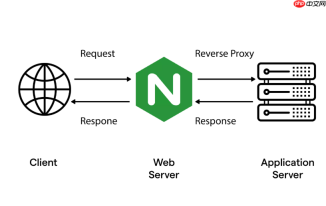
直接说结论:proxy_next_upstream_timeout 不是控制单次请求超时,而是限制**整个重试过程从第一次发起到最终放弃的累计耗时上限**。它一到时间就立刻终止所有后续尝试,返回 502 或 504,避免用户干等。
它到底管什么、不管什么
理解这个参数的关键在于“累计”和“全过程”:
- ✅ 它包含:首次连接建立、等待响应头、判定失败、切换到下一个 upstream、新建连接、再次发送请求、再次等待响应……所有环节的时间加总
- ❌ 它不包含:客户端与 Nginx 之间的超时(由 client_header_timeout 等控制)
- ❌ 它不叠加:proxy_read_timeout 仍独立生效,只决定“单次是否算失败”,不会因重试而延长总时间
- ❌ 它不重置:换服务器不会清空计时器,时间持续累加
不设会怎样?举个真实例子
假设 upstream 有 4 台后端,配置如下:

CPA Update - Secure CLI Proxy API Maintenance
下载
安全更新和维护 CLI Proxy API(CPA)部署与配置。用于 CPA 镜像升级、配置变更、认证目录兼容修复、上线验证与回滚。适用于用户提到“CPA 更新/升级/配置改了/容器重建/回滚”等场景。
- proxy_read_timeout 15s
- proxy_next_upstream_tries 4
- 没设 proxy_next_upstream_timeout
如果每台都卡在 14.9 秒才返回 504,用户最长可能等近 60 秒——这不是容错,是阻塞。设成 10s 后,第 10 秒一到就强制返回 502,体验可控。
怎么配才合理?看三个关键配合
单独设这个值没用,必须和另外两个参数形成梯度:
- proxy_connect_timeout:建议设为总窗口的 1/3 左右,比如目标总耗时 10s,这里设 3s,快速识别不可达节点
- proxy_read_timeout:设为业务合理响应头时间,比如 5–8s,它是触发 timeout 类重试的主要依据
- proxy_next_upstream_timeout:按 “proxy_read_timeout × 预期最大有效尝试次数” 估算并留余量。例如 proxy_read_timeout=5s、tries=3,建议设 8–12s(常用 10s)
必须同步启用的配套配置
只设 timeout 不够,还要确保以下几项已明确开启:
- proxy_next_upstream error timeout http_500 http_502 http_503 http_504:显式声明哪些错误可重试,避免误重试 4xx
- proxy_next_upstream_tries 3:限制最多尝试 3 次(含首次),防止反复打同一台故障机
- upstream 中 max_fails=2 fail_timeout=30s:让被动失败能快速标记节点下线,减少重试负担


