





nginx后端重启时应统一返回自定义维护页,需在location块中配置error_page 502=502 /maintenance.html、504=504 /maintenance.html,并启用proxy_intercept_errors on;同时确保/maintenance.html≥512字节且权限正确,配合upstream健康检查减少误判。
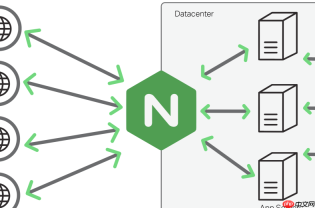
后端服务重启时,Nginx 代理请求会因连接失败或响应中断触发 504,但默认返回的是简陋文本页或浏览器兜底页。要让它“优雅”显示自定义页面,关键不是等超时发生后再处理,而是让 Nginx 主动识别并接管这类瞬时不可用状态,再统一渲染你设计的提示页。
确保 error_page 能捕获真实 504
504 只在 Nginx 已成功连上后端、但读取响应超时时生成。如果后端正在重启,常见表现是连接被拒绝(connection refused)或连接重置(connection reset),此时 Nginx 默认返回 502,而非 504。
- 先确认日志中实际报错类型:查
error.log是否出现connect() failed (111: Connection refused)或upstream prematurely closed connection—— 这些对应 502,不是 504 - 若确为 504,则必须在对应
location块中配置:error_page 504 =504 /maintenance.html;
注意=504中的等号,表示保留原始状态码,避免变成 200 - 该指令不能写在
http块顶层,必须放在能匹配到业务路径的location内(如location /api/ { ... }),否则不生效
让 502 也走同一套维护页逻辑
后端重启期间,绝大多数失败其实是 502(连接失败),而非 504(读超时)。所以仅配 504 不够,需一并接管 502:

- 添加:
error_page 502 =502 /maintenance.html;error_page 503 =503 /maintenance.html; - 同时开启拦截开关:
如果是 proxy_pass 代理(如 Java/Node.js),加proxy_intercept_errors on;
如果是 fastcgi(如 PHP),加fastcgi_intercept_errors on; - 确保
/maintenance.html文件存在、Nginx 用户有读取权限,且文件大小 ≥ 512 字节(否则浏览器会忽略,显示自身兜底页)
配合 upstream 健康检查减少误判
单纯靠错误码拦截,会在每次重启瞬间批量返回维护页,但用户可能刚点下按钮就撞上这个窗口。可借助健康检查提前感知:
- 在
upstream块中启用简单主动探测:upstream backend {<br> server 10.0.1.10:8080 max_fails=1 fail_timeout=10s;<br> keepalive 32;<br>}
这样当后端连续失败 1 次、10 秒内不参与负载,Nginx 会更快将流量切走 - 搭配
proxy_next_upstream off;关闭自动重试,避免一次请求反复打向已宕机节点,造成更长等待和重复日志 - 若用商业版 Nginx Plus 或 OpenResty,可用
health_check指令做 HTTP 探针,但开源版不支持
验证与日志区分真实原因
上线前需验证是否真返回了你的页面,且不掩盖问题本质:
- 在
log_format中加入$status $upstream_status $upstream_addr,例如:log_format main '$remote_addr - $remote_user [$time_local] "$request" $status $upstream_status $upstream_addr'; - 重启后观察日志:正常维护页应看到
502 502 10.0.1.10:8080或504 504 10.0.1.10:8080,而不是全变成 200 - 用
curl -I http://your-domain/api/test看响应头,确认Status是 502/504,Content-Type是text/html,内容是你写的 HTML


