





least_conn算法不感知网卡丢包,需依赖超时控制、健康检查和连接复用约束协同防御;配置proxy_connect_timeout、proxy_send/read_timeout、proxy_next_upstream及max_fails/fail_timeout可快速隔离丢包节点。
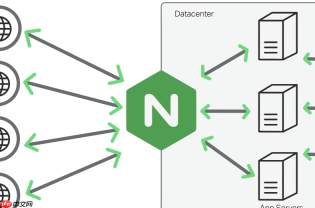
Nginx 的 least_conn 算法本身不感知网卡丢包,也无法直接识别或修复网络层问题。它只统计 Nginx 与后端之间已建立、尚未关闭的 TCP 连接数(即 ESTABLISHED 状态),而网卡丢包若未导致连接中断或超时,就会让这些“卡住但未断”的连接长期滞留在计数中——结果就是某台节点连接数虚高,least_conn 却仍把它当作“可用节点”持续分发新请求,加剧负载不均。
真正起作用的,是围绕 least_conn 构建的一套协同防御机制:健康检查 + 超时控制 + 连接复用约束。针对网卡丢包场景,关键在于让 Nginx 尽快发现并隔离那些因丢包而响应异常的节点。
网卡丢包如何引发连接数虚高
- 丢包导致 TCP 重传、ACK 延迟,后端响应变慢甚至超时,但连接未断(TCP 层仍认为 ESTABLISHED)
- Nginx 统计的活跃连接数持续上涨,却误判该节点“轻载可投”
- 新请求继续打过去,形成恶性循环:更多连接堆积 → 更多重传 → 更高延迟
必须配置的三项应对措施
-
缩短并分级设置超时参数
-
proxy_connect_timeout 3s:快速失败建连阶段的丢包影响 -
proxy_send_timeout 10s和proxy_read_timeout 15s:避免因丢包导致的长等待占用连接 - 所有 timeout 值应明显短于后端正常响应 P99 时间(例如后端 P99 是 800ms,timeout 设为 2–3s 较合理)
-
-
强制启用
proxy_next_upstream并包含timeoutproxy_next_upstream error timeout http_502 http_504; proxy_next_upstream_tries 2; proxy_next_upstream_timeout 5s;
一旦某次请求因丢包超时,Nginx 会立即重试另一台健康节点,并在
max_fails触发后将其临时剔除 -
为每个 server 显式配置
max_fails和fail_timeoutupstream backend { least_conn; server 10.0.1.10:8080 max_fails=2 fail_timeout=10s; server 10.0.1.11:8080 max_fails=2 fail_timeout=10s; }连续 2 次超时(由丢包引发)即标记为不可用,10 秒内不再参与
least_conn比较——这比等连接自然断开快得多

补充建议:验证与定位丢包节点
-
在 Nginx 侧开启日志字段:
log_format main '$remote_addr - $upstream_addr [$time_local] '
                 '"$request" $status $body_bytes_sent '
                 '$upstream_response_time $upstream_connect_time $upstream_header_time';
关注
upstream_connect_time和upstream_response_time是否出现集中性毛刺(如大量请求 connect_time > 1s 或 response_time > 10s) -
在后端机器上用
ss -i查看具体连接的重传统计:ss -tin | grep :8080 | awk '{print $1,$2,$3,$4}' | head -10若某 IP 的
retrans列频繁非零,基本可锁定为该链路存在丢包 配合
stub_status实时观察各节点 active connections 是否持续高于均值且波动小(典型“卡住不释放”特征)
不复杂但容易忽略的是:least_conn 的价值不在算法本身,而在它能否及时看到一个“干净”的候选池——而这个池的洁净度,取决于你是否用超时和健康检查把丢包带来的“幽灵连接”及时清出去。


