图片中的文字无法直接编辑,txt 文件又常因设备差异导致字体显示异常、换行错乱。处理这两类文件前,务必明确最终需求:是需要可自由编辑的文本内容,还是追求排版稳定的固定格式?再据此选择合适的方法。以下两种方案均基于极轻pdf(pdf.cn)真实可用的功能入口,不虚构“图片直转 word”或“txt 直接转 pdf”等不存在的操作流程。
方法一:图片先转PDF,完成OCR后再复制至Word
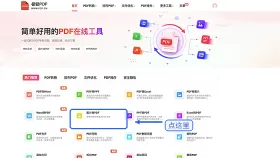
步骤一:在首页定位「图片转PDF」功能
进入极轻PDF官网首页,在「转为PDF」分类下准确找到「图片转PDF」工具。操作前请仔细辨认名称,避免误入「PDF转图片」页面。
步骤二:上传待识别的图片文件
进入该工具页面后,点击上传按钮,选择需处理的图片。支持多图批量上传,但请提前剔除重复页,并将横置、倒置图片手动旋转至正向。
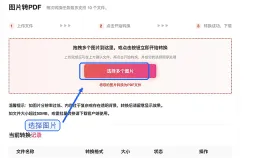
步骤三:检查图片预览、数量与顺序
上传完成后,逐一核对缩略图清晰度、总张数及排列逻辑。若存在模糊、裁切缺失或方向偏差,将显著降低后续OCR识别准确率。
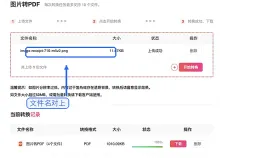
步骤四:执行图片合成PDF操作
确认无误后点击“开始转换”。过程中请保持页面开启,静待进度条完成即可。
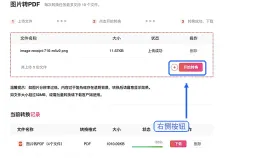
步骤五:下载生成的PDF文件
转换完成后下载PDF,打开验证每页是否完整、无缺失。此PDF即为下一步OCR识别的原始素材。
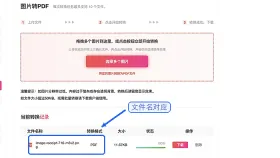
步骤六:返回首页启用「OCR PDF」功能
回到极轻PDF首页,在「文件优化」模块中找到「OCR PDF」工具——专用于提取扫描件或图像型PDF中的可检索文字。
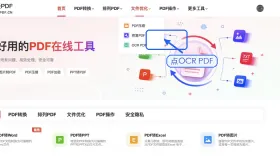
步骤七:上传刚生成的PDF文档
进入OCR页面后,点击「选择PDF文件」,上传上一步下载的PDF。单次任务请严格按当前页面限制上传,切勿混传不同项目资料。
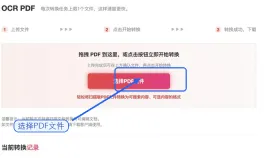
步骤八:确认文件上传状态
查看页面是否显示正确的文件名、大小及“已上传”标识。如发现命名错误,请立即删除并重新上传,防止识别对象出错。
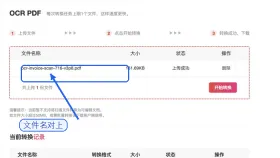

步骤九:启动OCR文字识别
点击“开始识别”,耐心等待处理完成。识别质量受原图清晰度、文字朝向及页面结构复杂度共同影响。
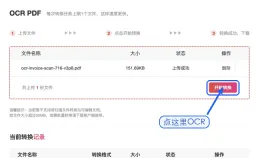
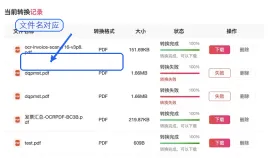
步骤十:下载结果并粘贴至Word校对
识别完毕后下载输出文件,打开测试文字是否可选中、可搜索。随后将所需内容复制进Word文档,并重点复核段落结构、数字、表格及专业术语——OCR结果必须经人工审校方可使用。
方法二:TXT内容先整理进Word,再导出为PDF
准备工作:将TXT内容规范化迁移至Word
使用系统自带或通用文本编辑器打开TXT文件,全选复制正文内容,粘贴至Word中;补充标题层级、合理分段,并统一设置基础字体与段落格式,最后保存为DOC或DOCX格式。提前完成这步,能有效规避TXT直接打印时常见的换行断裂、分页错位等问题。
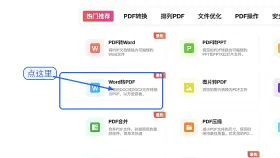
步骤二:在首页选择「Word转PDF」功能
访问极轻PDF首页,在「转为PDF」区域点击「Word转PDF」入口。
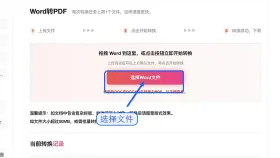
步骤三:上传已整理的Word文档
进入对应页面后,点击上传按钮,选取前述保存好的Word文件。
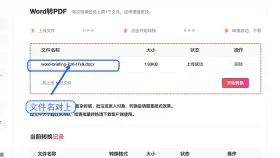
步骤四:核实上传文件信息
上传后检查文件名与体积是否匹配预期,确保所选为最新修订版本。
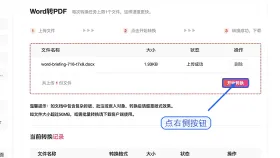
步骤五:执行转换操作
点击“开始转换”,等待Word内容渲染为PDF。若文档含特殊字体、文本框或大量分节符,生成后需重点核查版式还原度。
步骤六:下载并逐页验收PDF效果
进度完成后下载PDF,逐页比对标题位置、自动换行、分页逻辑及中文字符显示是否正常。若多次尝试仍失败,请整理好文件大小、错误截图、浏览器型号及详细操作步骤,发送至 market@pdf.cn 获取技术支持。