





nginx的least_conn算法无法感知gc停顿,需通过主动健康检查识别503、适配超时重试策略及连接管理三者协同解决。
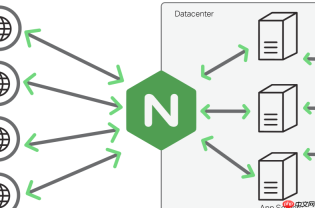
Nginx 的 least_conn 算法本身不感知 GC 停顿——它只统计每个后端当前活跃的 TCP 连接数,而 Full GC 导致的 STW(Stop-The-World)会让后端“卡住但不断连”,连接仍处于 ESTABLISHED 状态、未超时、也未返回错误。此时连接数可能维持在中低水平(比如 5–12),least_conn 会继续把新请求导过去,造成请求堆积、P95 延迟飙升,甚至引发网关 504。
真正要解决的,不是改算法,而是让 Nginx 能识别“卡住”并绕开它。关键在三件事:让后端主动暴露压力、让 Nginx 主动探测异常、让超时策略匹配 GC 特性。

在 Java 中初始化和管理阿里云 SDK客户端。包括单例模式、线程安全、endpoint 与 region 配置、VPC 终端节点、同步与异步等。
后端需主动暴露 GC 压力
不能等它彻底失败才反应。建议在健康检查端点(如 /actuator/health)中嵌入 GC 指标判断逻辑:
- 若最近 60 秒内 Full GC 次数 ≥ 3 次,或单次 GC 停顿 > 800ms,主动返回 HTTP 503;
- Nginx 主动健康检查(
health_check match=http_503)即可立即摘除该节点,无需等连接堆满。
Nginx 必须启用敏感的主动健康检查
被动检查(靠 proxy_next_upstream timeout error)对 GC 卡顿无效——它不报错、不超时(除非你设得很短),只是响应慢。必须配主动探测:
- 每 2–3 秒发起一次 HTTP GET 请求到健康端点;
-
fails=2 passes=2,确保快速剔除、平稳恢复; - 配合
match规则识别 503 或超时响应,而非仅看 2xx。
超时与重试策略要适配 GC 的“间歇性假死”
GC 停顿是秒级突发,不是永久故障。Nginx 需“有耐心但不盲等”:
-
proxy_read_timeout设为 120–180 秒(覆盖典型 GC 尖峰); - 同步开启
proxy_next_upstream timeout http_503 http_504; - 加上
proxy_next_upstream_tries 2和proxy_next_upstream_timeout 15s,让单次请求最多重试 1 次,且总耗时可控; - 关键:关闭缓冲
proxy_buffering off,避免因缓冲区满提前断连。
连接复用与限流防止“慢节点吸血”
GC 卡顿期间,若连接复用不当,会虚高连接数或掩盖真实负载:
-
upstream中设keepalive 16–32(不宜过大),避免空闲连接长期占位; - 后端开启连接池(如 Tomcat
maxKeepAliveRequests=100),并设connectionTimeout>proxy_read_timeout; - 给慢节点加
max_conns=500等硬上限,一旦连接数触及即跳过,相当于动态限流。
不复杂但容易忽略——least_conn 是调度器,不是监控系统。它需要健康检查当眼睛、超时策略当神经、连接管理当肌肉,三者协同,才能把 GC 卡顿从“不可见延迟”变成“可隔离故障”。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


