





proxy_read_timeout调大仅延长等待时间,不能根治后端响应慢;需先区分是响应头未返回(查proxy_connect_timeout等)还是响应体传输慢,再按路径精准配置超时、同步调整send_timeout等参数,并确保后端超时小于nginx值、流式接口关闭buffering。
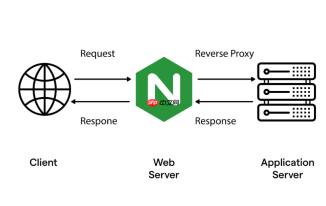
直接调大 proxy_read_timeout 不能解决“后端响应极慢”本身,它只是让 Nginx 多等一会儿——但若不配合定位、隔离和协同调优,反而会放大问题:连接堆积、worker 占用、资源耗尽。关键不是堆数字,而是让这个 timeout 发挥精准控制作用。
先确认是真慢,还是卡在开头
proxy_read_timeout 只管“后端已返回响应头之后,等响应体数据的空闲时间”。如果日志里出现 upstream timed out while reading response header from upstream,且 $upstream_response_time 接近 0 或很小(比如 0.002 秒),说明后端连响应头都没发出来,问题不在 proxy_read_timeout,而在:
-
proxy_connect_timeout:Nginx 连不上后端(网络、防火墙、端口未开) - 后端启动失败或进程僵死(如 Java 应用 OOM 后无响应)
- 上游排队严重(如 Tomcat 线程池满,请求压在队列里)
按路径精准设值,避免全局污染
轮询下多个后端节点性能不一,响应慢的接口(如 /api/export、/report/generate)必须单独配置,不能把所有 location 都设成 600 秒:

FastAPI + Flask 混合部署最佳实践,解决路由定义、API 代理等常见问题,适用于同时运行 FastAPI API 与 Flask 前端的场景。
- 普通 API 接口(
/api/user、/auth/login):保持默认或设为 15–30 秒,防止慢节点拖垮整体 - 明确的长耗时路径:用独立
location块包裹,例如:location /api/export/ {<br> proxy_pass http://backend;<br> proxy_read_timeout 300;<br> proxy_connect_timeout 10;<br> proxy_send_timeout 300;<br> send_timeout 300;<br>}
必须同步调这三项,单改无效
proxy_read_timeout 不是孤岛参数。轮询场景下,一个慢节点卡住,会牵连整个 upstream 的连接复用效率:
-
proxy_send_timeout≥proxy_read_timeout:确保大请求体(如带附件的 POST)能完整发过去,否则还没传完就被断 -
send_timeout≥proxy_read_timeout:保证用户下载导出文件时,弱网下 Nginx 不会提前关闭 client 连接 -
upstream块中启用keepalive 32,并配proxy_http_version 1.1和proxy_set_header Connection '':避免每次请求重建 TCP 连接,浪费握手时间
后端超时必须比 Nginx 小,留出判断余地
如果后端(如 Spring Boot 的 server.tomcat.connection-timeout)设为 300 秒,而 Nginx 的 proxy_read_timeout 也设 300 秒,结果往往是 Nginx 和后端几乎同时断连,日志混乱、状态难判。建议:
- 后端超时设为 Nginx 值的 0.7–0.8 倍(如 Nginx 设 300 秒,后端设 240 秒)
- 这样 Nginx 能明确捕获“后端主动断连”,返回 502 而非模糊的 504,便于定位是后端崩溃还是业务阻塞
流式响应要关缓冲,否则假超时
对导出 Excel、SSE 日志、AI 流式输出这类接口,Nginx 默认开启 proxy_buffering on,会攒够一整块才转发。看起来像“卡住”,实则是 buffer 满了才吐——这时调大 proxy_read_timeout 没用:
- 加
proxy_buffering off;在对应 location 中 - 可选加
chunked_transfer_encoding on;,提升分块传输兼容性 - 注意:关 buffering 后,需确保后端确实持续输出,否则空闲期仍会触发
proxy_read_timeout


