





Nginx代理超时(如504、upstream timed out)是网卡丢包在应用层的间接体现,需通过error.log异常模式定位目标IP,再结合ss -i、netstat -s和ethtool等系统指标锁定具体网卡及丢包方向。
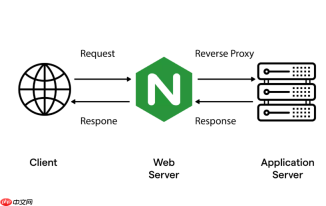
Nginx 代理超时本身不直接暴露“网卡丢包”,但当特定网卡出现丢包时,会引发一系列可观察的超时报错(如 504 Gateway Timeout、upstream timed out、Connection reset by peer),这些错误是丢包在应用层的间接体现。排查需跳出 Nginx 单点日志,建立“Nginx 行为 → TCP 连接状态 → 网卡级指标”的链路验证。
看 Nginx error.log 中的超时信号是否集中指向某台 upstream 或某个网卡出口
Nginx 不记录丢包,但会忠实记录因丢包导致的失败行为。重点筛查以下日志模式:
-
upstream timed out (110: Connection timed out):说明 Nginx 向后端发了请求,但迟迟没收到响应。若该错误集中在某一个 upstream server IP(比如10.201.0.27:8888),且该 IP 恰好走的是 eth1 而非 eth0,就要怀疑 eth1 链路异常 -
recv() failed (104: Connection reset by peer):对端主动 RST,常见于中间设备(如防火墙、负载均衡器)因丢包/乱序触发连接清理,或对端内核丢弃了重传包后强制断连 -
*n connect() failed (111: Connection refused)大量出现但仅限某网卡路由路径:可能因丢包导致健康检查失败,Nginx 主动摘除节点
建议用 grep -E "upstream timed out|reset by peer|Connection refused" /var/log/nginx/error.log | awk '{print $NF}' | sort | uniq -c | sort -nr 快速定位异常目标地址。
用 ss -i 和 netstat -s 锁定丢包发生在哪张网卡的哪个方向
Nginx 日志只能提示“哪里连不上”,真正确认丢包必须下到系统层,并绑定到具体网卡:
查单条连接重传与接收窗口:
ss -i dst 10.201.0.27:8888
关注字段:retrans(重传次数)、rto(重传超时值突增说明链路不稳定)、qloss(接收队列丢包数,非零即内核已丢)
若rcv_space长期为 0,说明接收缓冲区被填满,可能是上游持续小包涌来 + 本机处理慢 + 网卡中断延迟高,最终触发丢包查全网卡统计级丢包:
netstat -s | grep -A 5 -B 5 "packet loss"
或更精准:cat /proc/net/snmp | grep -A1 Tcp | grep -E "(InSegs|OutSegs|RetransSegs)"cat /proc/net/snmp | grep -A1 Ip | grep -E "(InReceives|InDiscards|InDelivers)"
特别关注InDiscards(输入丢弃)和OutDiscards(输出丢弃)。若 eth1 的InDiscards明显高于 eth0,说明该网卡接收队列溢出,常见于中断未及时处理或 ring buffer 满验证物理层:
ethtool eth1 | grep -E "(dropped|over|errors)"
关键字段:rx/tx dropped(驱动层丢包)、rx/tx overruns(ring buffer 溢出)、rx/tx errors(CRC/帧错误)。若rx_dropped > 0且持续增长,基本可判定是这张网卡或其上游交换机端口存在问题
结合路由与连接跟踪,排除 iptables/nf_conntrack 干扰

丢包未必来自网络设备,也可能是本机策略拦截:
检查是否走错网卡:
ip route get 10.201.0.27—— 确认实际出口是 eth1,而非预期的 eth0;若路由异常,会导致流量误入低带宽或高丢包链路检查连接跟踪是否耗尽:
sysctl net.netfilter.nf_conntrack_count与net.netfilter.nf_conntrack_max对比。若接近上限,新连接会被静默丢弃,表现为connect() failed (113: No route to host)或无日志的连接失败检查 iptables DROP 计数:
iptables -nvL INPUT | grep -E "(DROP|REJECT)"iptables -nvL FORWARD | grep -E "(DROP|REJECT)"
若某条规则pkts列数值明显上升,尤其匹配目标端口(如 8888)或源网段,说明是防火墙策略在丢包,而非网卡硬件问题
复现并隔离:用 tc 模拟丢包,验证 Nginx 超时行为是否一致
若线上无法高频抓包,可在测试环境复现:
- 在 eth1 上注入 3% 丢包:
tc qdisc add dev eth1 root netem loss 3% - 发起压测请求,观察是否复现相同
upstream timed out频次与日志特征 - 同时运行
ss -i dst 10.201.0.27:8888,确认retrans和qloss是否同步上升 - 恢复命令:
tc qdisc del dev eth1 root
这一步能闭环验证:Nginx 超时是否确实由该网卡丢包引发,而非后端性能问题。


