





nginx超时降级需变被动等待为主动决策:通过error_page拦截502/503/504统一返回轻量json;结合proxy_cache_use_stale提供过期但可用缓存;用map+lua按路径或指标动态调优超时阈值;降级响应添加header与日志字段实现可观测性闭环。
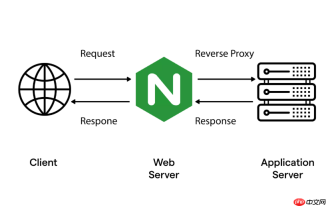
Nginx 代理超时在高并发突发流量下不能只靠调大 proxy_read_timeout 或 proxy_connect_timeout,那样只是硬扛,容易引发级联超时、连接堆积、后端雪崩。真正平稳降级的关键,是把“超时”从被动等待,变成主动决策点——在超时发生前或刚触发时,就切换响应策略,把不可控的等待,转为可控的退让。
用 error_page 拦截超时错误,统一返回轻量兜底响应
Nginx 的 proxy_next_upstream 和 error_page 组合,是实现超时降级最直接、零依赖后端的方式:
- 在 upstream 或 location 中启用超时重试与错误识别:
proxy_next_upstream error timeout http_500 http_502 http_503 http_504;
proxy_next_upstream_tries 2;
proxy_next_upstream_timeout 3s;
- 然后在 server 或顶层 location 中统一拦截:
error_page 502 503 504 =200 @timeout_fallback;
location @timeout_fallback {
    internal;
    add_header X-Downgraded "timeout";
    return 200 '{"code":503,"msg":"服务繁忙,请稍后再试","data":{}}';
}
这样,只要上游响应超时(或返回 5xx),Nginx 就不等、不重试、不抛错,立刻返回预设 JSON,毫秒级生效,前端可据此展示友好提示或自动降级 UI。

结合 proxy_cache_use_stale 实现“过期但可用”的缓存兜底
当突发流量导致后端大面积超时,用户其实能接受“稍旧但能用”的数据,而不是白屏或报错:
- 开启 stale 策略,允许 Nginx 返回已过期缓存:
proxy_cache_use_stale error timeout updating http_500 http_502 http_503 http_504;
proxy_cache_valid 200 302 10s;
proxy_cache_valid 503 5s;  # 对降级响应也缓存,快速传播状态
proxy_cache_lock on;       # 防止缓存失效时大量回源
- 配合
proxy_cache_bypass $is_downgraded;,让降级开关同时绕过缓存,确保人工干预即时生效。
用 map + Lua 动态调整超时阈值,按路径/流量特征分级控制
全局固定超时值(如统一设 10s)不合理。支付接口可能需 3s 内响应,而报表导出允许 30s:
- 定义差异化超时变量:
map $request_uri $proxy_timeout { default 10; ~^/api/v1/payment 3; ~^/api/v1/report/export 60; ~^/healthz 1; } - 在 location 中引用:
proxy_connect_timeout $proxy_timeout;
proxy_send_timeout    $proxy_timeout;
proxy_read_timeout    $proxy_timeout;
再配合 Lua 脚本,可进一步根据 QPS 或错误率动态收紧:比如当前
/api/search错误率 > 25%,就把$proxy_timeout临时压到 2s,加速失败判定,避免请求长时间挂起。
降级响应自带可观测性,便于闭环判断与恢复
平稳降级不是掩盖问题,而是把“超时”变成可追踪、可统计、可联动的信号:
- 所有降级响应加自定义 Header:
add_header X-Proxy-Timeout-Degraded "true"; - 日志格式中记录触发原因:
log_format main '$remote_addr - $remote_user [$time_local] ' '"$request" $status $body_bytes_sent ' '"$http_referer" "$http_user_agent" ' 'upstream_status:$upstream_status ' 'degraded:$is_downgraded ' 'timeout_reason:$upstream_http_x_timeout_reason'; - 配合 Prometheus 抓取
nginx_vts_server_requests_total{code="503",reason="timeout"}指标,设置告警:连续 1 分钟 timeout 降级率 > 5%,自动触发运维检查或切流预案。
本质上,Nginx 层的超时降级,不是延长等待时间,而是压缩不确定性——把“等还是不等”的模糊判断,变成“何时降、怎么降、降给谁”的明确规则。


