cursor tab补全反应慢是因语义匹配失败、上下文过载、本地模型未预热或tls握手抖动;需先验证基础功能,再检查启用状态、上下文管理、网络链路及调低触发阈值。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
Cursor Tab补全反应慢不是单纯“网速差”或“电脑卡”,而是AI补全请求在三层语义匹配中某一层被筛掉、上下文窗口过载、本地模型未预热,或网络链路在TLS握手阶段就已抖动——这些环节任一卡顿,用户看到的都是光标静止、Tab无响应。
先确认是不是真慢,还是根本没触发
打开一个全新空项目(比如新建一个test.ts),输入const a = 1;再换行写a.,按Tab。如果此时有补全弹出,说明基础能力正常;若完全无反应,问题出在补全开关或语言支持层。
进入Settings → 搜索“code completion” → 确保【Enable AI completions】和【Trigger on typing】两个选项都已勾选。
在Language-specific settings里,找到当前文件类型(如TypeScript),单独启用AI补全——很多项目默认只开JavaScript,TypeScript需手动开。
排查上下文过载导致的延迟
Cursor的Tab补全依赖实时语义评分,当编辑器当前视图中可见代码行数<40行,或折叠了超过3个函数体,模型将因上下文碎片化而大幅降分,直接跳过补全。
展开所有折叠区域,滚动使至少80行连续代码处于可视区;不要靠“滚动条拖到底部”来凑行数,必须是编辑器窗口内真正渲染出来的连续文本。
右键项目根目录 → Add to Context → 仅勾选核心类型定义文件(如types.ts、index.d.ts),【严禁把node_modules或dist目录加入Context】,否则上下文token瞬间冲破8192上限,补全引擎直接拒绝响应。
检查网络与模型服务链路
方法一:用DevTools抓包定位卡点
启动Cursor时加参数:--remote-debugging-port=9222 → 访问http://localhost:9222 → 打开Network面板 → Preset log保持开启 → 输入触发Tab → 查看/v1/completions请求:
若首字节延迟>800ms,且响应头含X-Cursor-Backend: local,说明本地模型加载失败,运行cursor --inspect-models验证GPU显存占用与模型状态;
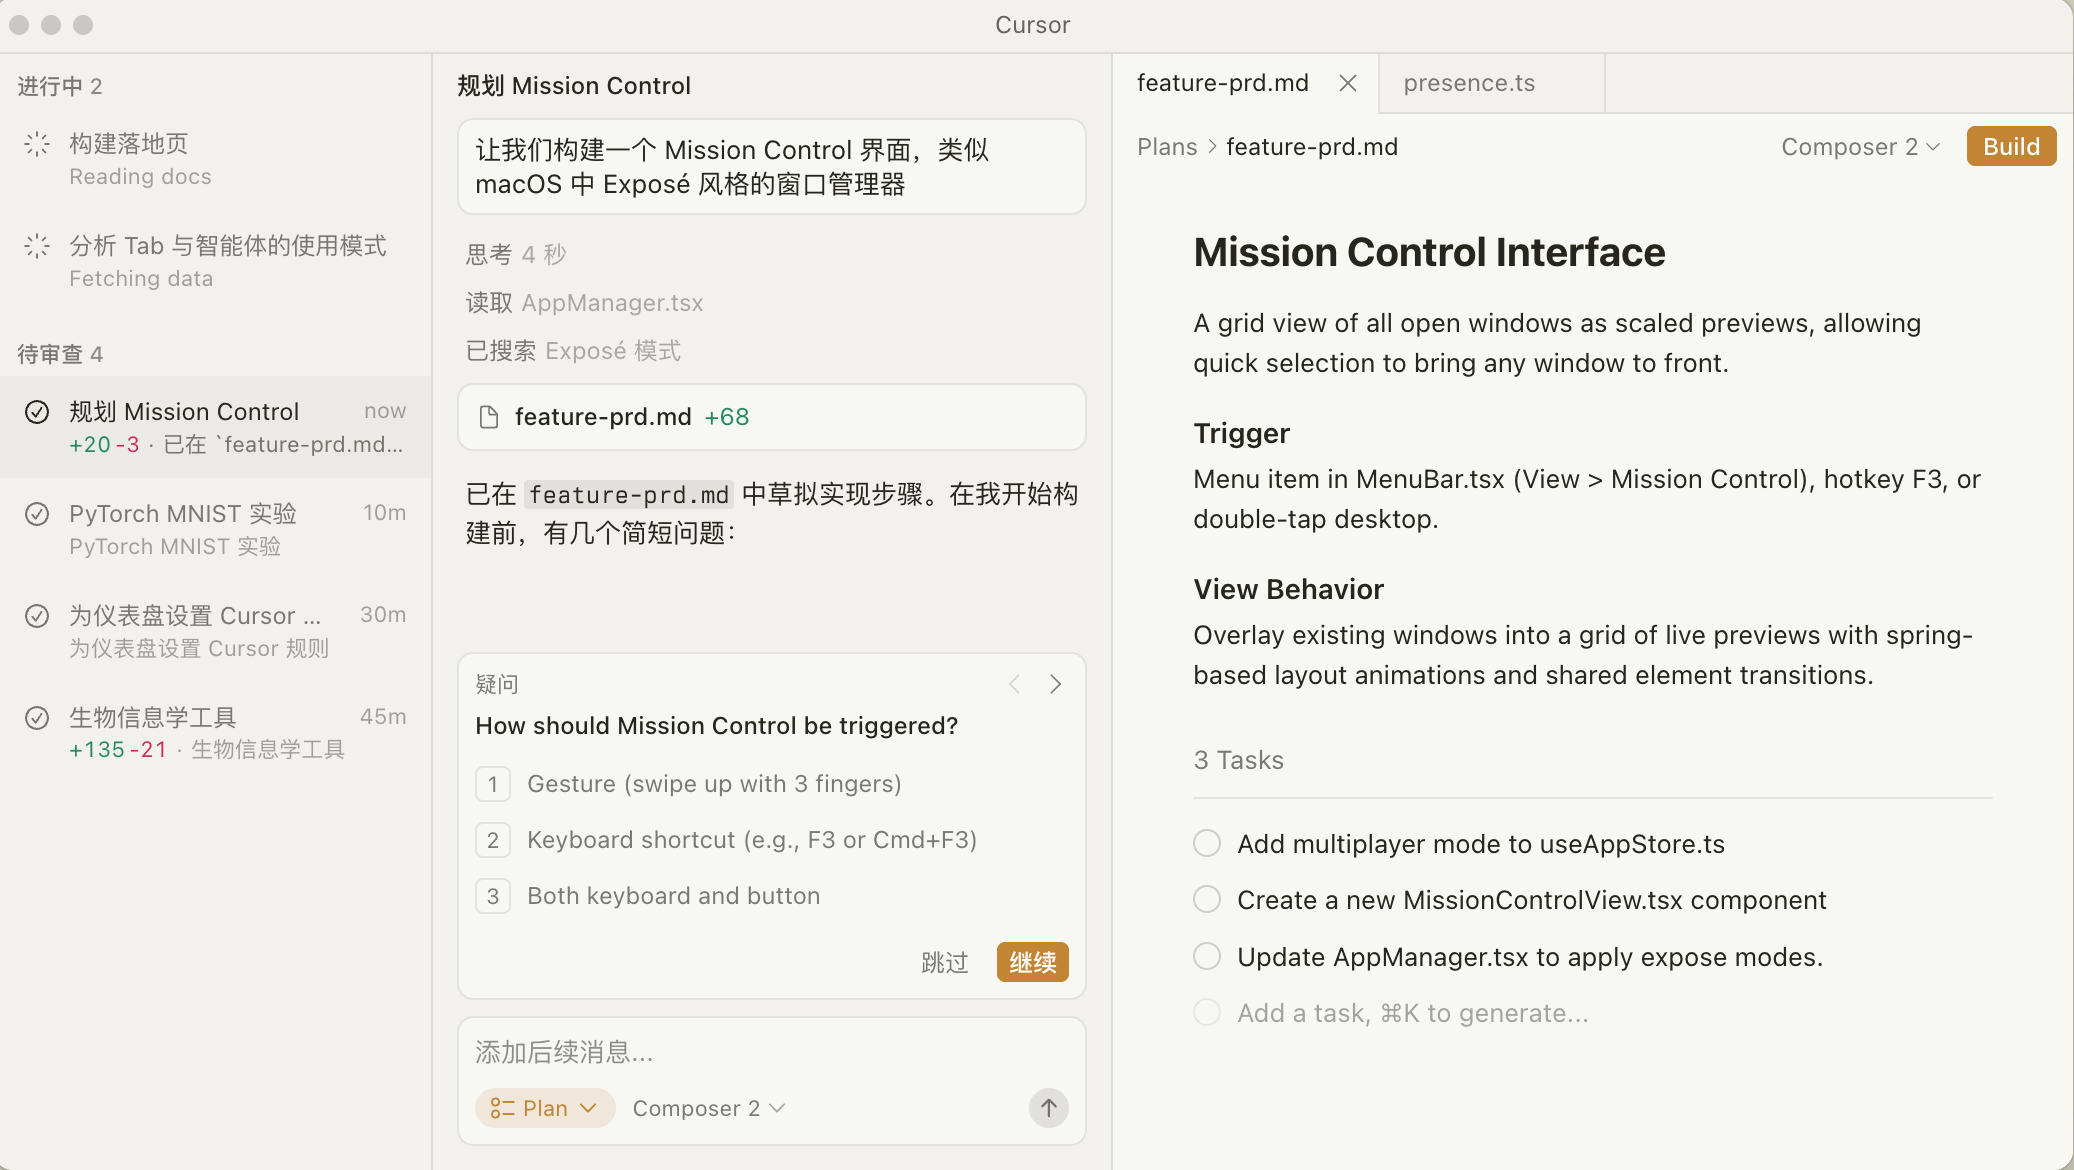
Agents 正在你的整个代码库中处理越来越复杂、运行时间更长的任务。本次版本引入了新的 agent 框架改进,以实现更好的上下文管理,并在编辑器和 CLI 中带来了许多提升使用体验的修复。
若响应体大小>2MB且无Content-Encoding: gzip,说明压缩未启用,在settings.json中添加:"cursor.completion.enableGzip": true。
方法二:快速交叉验证
打开终端,执行:curl -s http://localhost:5001/health | jq '.status' → 返回"ok"表示后端存活;若报错或超时,清除缓存:rm -rf ~/.cursor/cache/completion,重启Cursor。
调低补全阈值让提示更积极
第一步:打开Command Palette(Cmd+Shift+P / Ctrl+Shift+P)→ 输入“Open Settings (JSON)” → 回车;
第二步:在settings.json末尾插入以下两行:
"cursor.completion.contextScoreThreshold": 0.5,
"cursor.completion.maxContextTokens": 4096
第三步:保存文件,重启Cursor。默认阈值0.65对中小项目过于保守,0.5能显著提升补全触发率,尤其在跨文件引用不强的模块中;
注意:该修改不会降低补全质量,只是放宽“是否值得补全”的判定门槛——模型仍会基于完整上下文生成建议,只是不再因得分略低于0.65就直接丢弃。