





nginx event loop 本身不避免延迟,而是通过精准响应、资源隔离和关键路径优化压低网络事件处理延迟;优化需聚焦内核通知延迟(如调小timer_resolution)、事件分发效率(如reuseport)、handler阻塞(如禁用同步i/o)及系统资源竞争(如cpu亲和性)。
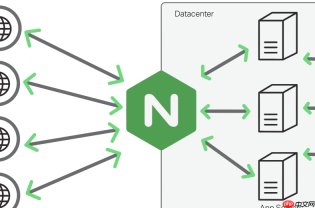
Nginx 的 Event Loop 本身不“避免”延迟,而是通过一整套协同设计,在操作系统约束下把网络事件处理延迟压到最低。它不靠猜测或预测,而是靠精准响应、资源隔离和关键路径优化。
Event Loop 响应网络事件的本质是被动等待 + 快速分发
它不轮询,也不主动探测连接状态,只等内核(epoll/kqueue)通知“这个 socket 就绪了”。真正影响延迟的,是通知是否及时、分发是否高效、后续处理是否卡顿。所以优化方向很明确:减少内核通知延迟、加快事件分发链路、防止 handler 执行被拖慢。
关键环节的延迟来源与应对方式

内核通知延迟
epoll_wait() 的 timeout 参数决定空闲时等待多久才返回。默认可能几百毫秒,尤其在低流量时。
→ 设置timer_resolution 100ms;(或更小),强制 Event Loop 更频繁地检查定时器和就绪事件;
→ 确保系统未开启节能模式(如 intel_idle.max_cstate=1),避免 CPU 进入深睡眠导致唤醒延迟;
→ 检查epoll_wait调用耗时(可用 perf 或 eBPF 工具),确认是否因锁争用或回调堆积拉长等待。事件分发与连接接纳效率
新连接要经过 accept 队列 → Nginx 调用 accept() → 创建连接对象 → 注册读事件,每一步都可能排队。
→ 启用listen 80 reuseport;,让内核把新连接直接分发到多个 worker,避免单队列瓶颈;
→ 增大listen 80 backlog=4096;并同步调高net.core.somaxconn,防止队列溢出丢包;
→ 高并发场景下设accept_mutex off;,减少多 worker 竞争监听锁的开销(需搭配 epoll 使用)。handler 执行被阻塞
Event Loop 是单线程的,一旦某个 read/write handler 执行太久(比如同步写磁盘、调用阻塞 Lua 函数),整个队列都会卡住。
→ 禁止在init_worker_by_lua*或access_by_lua*中执行阻塞系统调用(如 os.execute、io.open 同步读);
→ 日志写入改用access_log /path/log.log buffer=64k flush=1s;,避免每次请求都刷盘;
→ 对 TLS 握手密集的场景,启用ssl_buffer_size 4k;减少 handshake 包碎片,降低内核协议栈压力。系统级资源竞争干扰
Event Loop 再快,也跑在 OS 上。CPU 调度不均、内存回收、软中断过载都会拖慢它。
→ 绑定 worker 到专用 CPU 核心:worker_cpu_affinity auto;或显式配置;
→ 监控pidstat -p $(pgrep nginx) 1,若%wait持续 >10%,说明进程在等 CPU 调度;
→ 查看sar -I NET_RX 1,单核软中断超 70% 时,需启用 RPS 或网卡多队列分流;
→ 内存紧张时,kswapd回收会阻塞 socket 内存分配,可调低vm.swappiness=1缓解。
不复杂但容易忽略——延迟不是 Event Loop “慢”,而是它上下游某个环节卡住了。定位时优先看 ss -lnt 的 Recv-Q、netstat -s 的 listen overflows、以及 pidstat 的 wait 时间,比调优代码更直接有效。


