





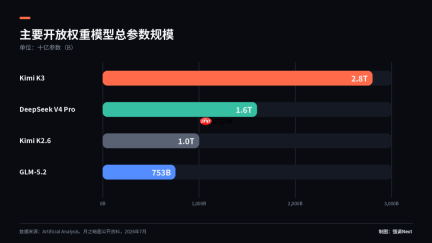
7月27日晚,月之暗面如期将kimi k3的完整模型权重发布至hugging face、github与modelscope平台。2.8万亿参数,全球首个跨过3万亿门槛的开源大模型,支持免费下载、本地部署及二次开发。
十天前,马斯克刚在K3相关评测报道下留言“Impressive”,旋即在社交平台宣布:xAI旗下2万亿参数新模型将于下周完成初训,“或超越Kimi”。Kimi官方仅回应一句:“欢迎马斯克加入2万亿俱乐部。”
紧接着,它干脆拆掉了俱乐部的大门:你们还在比谁参数多?抱歉,最大的那个,我们直接白送。
这显然不是出于情怀。梳理月之暗面近一个月的动作:6月中旬ARR(年度经常性收入)突破3亿美元,API收入占比超七成;7月19日起暂停C端新用户订阅;上一轮200亿美元估值融资刚交割完毕,新一轮投前估值已喊至315亿美元。
细心的开发者发现,在Hugging Face上约1.56TB的模型文件旁,一份仅3.07KB的许可证,悄然透露出更多商业信号。
根据Kimi K3 License条款,若企业从事“模型即服务”(MaaS)业务,且其自身及关联方在任意连续12个月内合计营收超过2000万美元,则在将K3或其衍生模型用于商业用途前,须与月之暗面另行签署协议。
这份许可证,把K3的讨论焦点从技术拉回了生意本质。
01 月之暗面不愿为云厂商无偿代工
开源模型长期面临一个现实困境:模型公司承担高昂训练成本,而云厂商却可能攫取后续主要收益。这也是百度李彦宏此前直言“开源模型难有前景”的底层逻辑。
依据MIT许可证,云厂商可自由下载模型、优化推理、封装为API,并依托既有客户群、算力资源与销售渠道收费。模型方虽获得下载量与行业声望,但客户关系、调用数据与账单流水,全留在云平台手中。模型迭代越快,实验室越容易沦为云厂商的上游研发车间。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
K3许可证中所指“模型即服务”,特指第三方对输入、参数或训练数据具备实质性控制权。将K3能力嵌入自家产品某一具体功能,或仅作请求转发至其他平台,均不在此列。
换言之,月之暗面并未限制开发者与大多数企业用户,它真正设防的对象,是那些下载权重、封装成API、再以自有品牌与定价对外销售推理服务的云厂商与专业推理平台。
海外已有专注开源基础设施的分析人士,将这一门槛与十年前的经典案例相提并论。
MongoDB、Confluent早年亦采用宽松许可证快速扩大生态规模。待亚马逊等云厂商将其开源数据库直接打包为收费云服务,原厂却无法分润时,它们才被迫转向SSPL、BSL等限制转售的许可协议。
先以开放换规模,再借规则夺回议价权。从超大规模云服务商,到Fireworks、Together这类专注模型托管的推理平台,理论上均被2000万美元年营收门槛覆盖。K3面对的,是与MongoDB、Confluent高度相似的商业挑战,但选择了更柔性的法律路径:不直接禁止MaaS转售,而是要求达标经营者另行签约。
开源模型行业已悄然越过“比谁先开源”“比谁开源得更彻底”的阶段,迈入“比谁能从开放生态中重掌定价权”的新周期。
同样是7月释放权重,智谱GLM-5.2与DeepSeek V4 Pro仍沿用标准MIT协议,未设任何转售限制。当然,这未必源于更大方。
至于月之暗面口中可豁免该条款的“认证推理伙伴”,其准入标准与名单至今未公开,许可证原文亦未作定义。
02 从“卷参数”转向“卷场景”
许可证只是K3商业策略的一环。回归模型本体,K3、DeepSeek、GLM与千问已各自走出四条差异化路径。
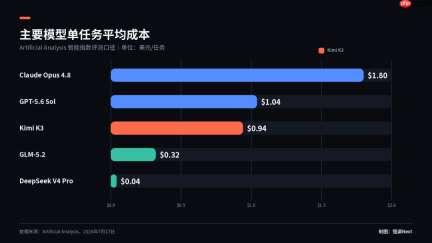
K3走的是“大而全”路线。2.8万亿总参数、百万token上下文长度、原生视觉理解能力俱备。官方演示中,K3从零构建GPU编译器、参与芯片设计、生成3D开放世界游戏。但其成本也最高:每百万token输入3美元、输出15美元,单任务平均成本约0.94美元。
DeepSeek V4 Pro则反其道而行之。总参数达1.6万亿,激活参数却压缩至约490亿。输入与输出单价分别为0.435美元和0.87美元,单任务成本仅约0.04美元。
DeepSeek还引入峰谷定价机制:9:00–12:00、14:00–18:00时段费用翻倍,错峰使用可节省一半成本。这与其一贯风格一致——参数可以庞大,但激活规模与实际使用成本必须极致可控。
智谱GLM-5.2选择第三条路径。它升级采用DeepSeek Sparse Attention技术,将百万token上下文推理开销压至通用硬件可承受范围;配合约400亿单token激活参数,实现三家中最短首字延迟。
GLM-5.2输入与输出价格分别为1.4美元与4.4美元,介于K3与DeepSeek之间,主攻编码与Agent场景下的响应速度。
阿里千问不追求单项极致,专注广度覆盖。支持上百种语言、具备更完整的多模态能力,使其更像面向企业客户的通用底座,而非专为跑分打造的旗舰型号。

使用 @youdotcom-oss/teams-anthropic 将 Anthropic Claude 模型(Opus、Sonnet、Haiku)添加到 Microsoft Teams.ai 应用程序中。可选集成 You.com MCP 服务器以进行网页搜索和内容提取。
不过Kimi此举也让阿里坐不住了——K3发布仅三天,阿里即预告Qwen3.8-Max,参数达2.4万亿,并明确表示将开放权重。过去一年,开源模型的规模天花板有9个月由Kimi持续抬升。如今,旗舰级开源权重正成为中国大模型厂商的标配动作。
四条路径已无法用单一维度排序。“卷参数”正加速转向“卷场景”:长文本处理看K3,性价比首选DeepSeek,响应速度盯GLM,多语言多模态覆盖认千问。
差异化并不等于高枕无忧。DeepSeek、GLM与千问随时可能进一步强化各自优势,K3在价格上的短板也不会自动消失。
03 闭源模型的溢价空间正被压缩
真正让本轮开源模型引发广泛关注的,是性能与价格的双重对比。
在第三方评测机构Artificial Analysis发布的智能指数榜单中,K3得分约为57分。排在其前方的是Claude Fable 5(约60分)与GPT-5.6 Sol(约59分);Claude Opus 4.8则以约56分紧随其后。
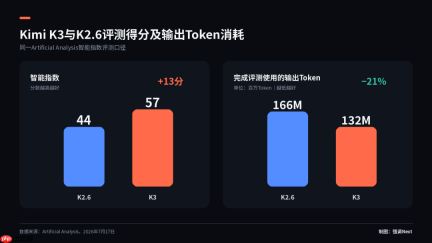
这是首次有开源权重模型在综合能力上逼近顶级闭源模型,差距仅两三分。在Arena前端代码榜单上,K3上线24小时内跃居榜首,反超Claude Fable 5,较上一代提升17个位次。
更关键的是,这些接近世界顶尖的表现,对应的价格显著低于多数闭源旗舰。
K3单任务平均成本约0.94美元,约为Claude Opus 4.8的一半。倘若闭源模型的溢价建立在“唯我独有能力达成此水平”的前提之上,那么当一款开源模型将性能差距缩至两三分,价格却仅为一半左右,这套溢价逻辑的解释力正在迅速瓦解。
微软CEO纳德拉称之为“反向信息悖论”:采购闭源模型,实则支付了两次费用——一次是账单金额,另一次是喂给模型的业务know-how。
今年1月,纽约一家法院裁定OpenAI须提交2000万条脱敏用户对话,更给所有企业敲响警钟:数据存于他人服务器,自主权便不由你掌控。K3所提供的,正是那个“数据不出墙”的确定性选项。
04 权重只是序章,真正的战场在推理层
开放权重,在这个阵营里早已不是新鲜事。DeepSeek、GLM与千问的旗舰模型早已登陆Hugging Face,下载、商用与微调皆无障碍。
K3此次真正带来突破感的,恰恰是权重之外的部分。
由于KDA重构了传统前缀缓存机制,月之暗面将自研缓存实现直接贡献至vLLM项目。权重上线当日,vLLM与SGLang两大主流推理引擎同步推出部署方案;AMD团队完成MI355X芯片首日适配;云平台Modal上线K3托管服务;Inferact则训练并开源了适配K3的DSpark投机解码器。
vLLM给出的最低可行部署配置为:8张英伟达B300或8张AMD MI355X。这两款均为尚未大规模铺货的数据中心顶级芯片,所需算力远超个人开发者能力边界。
这意味着,月之暗面所图不止于“模型更大”这一 headline。它更希望在推理框架与部署工具链中占据一席之地。
权重谁都能开源。但若开发者所依赖的服务方案、缓存实现与投机解码器,全都围绕你的架构构建,更换模型的成本就不再只是“换一个文件”那么简单。
许可证中“经认证推理伙伴使用可豁免转售条款”的设计,又赋予月之暗面一道开关:谁能接入这套生态,谁需提前谈判,均由其自主筛选。
开放权重是一次性动作,深度嵌入工具链才有可能真正绑定开发者。正因如此,K3此次开源权重,更宜视作起点,而非终点。
但定制化规则同样伴随代价。大型企业在选用开源模型时,看重的不仅是能力与成本,还有许可证是否简洁、稳定。MIT与Apache 2.0广受欢迎,正因其法务边界清晰、判断成本低。
K3新增了收入门槛、关联方口径、MaaS定义及认证伙伴等多重条件,企业部署前需投入更多合规审查。若GLM、DeepSeek或千问推出能力相当、许可证却更简明的替代方案,平台完全可能绕开K3。
开源模型本就具备较低迁移成本。一次发布带来的技术领先,难以长期支撑一套自定义规则体系。
据悉,K3.1已在推进中,最快下月亮相,“开源—验证—迭代”这套打法,或许才刚刚进入实战检验阶段。
本文来自微信公众号 “强调Next”(ID:leo89203898),作者:新见,36氪经授权发布。





