





偶发性硬件故障需依赖被动健康检查而非权重,应设max_fails=1、fail_timeout=10s,配合proxy_next_upstream覆盖全部失败类型,并用backup节点兜底,再通过iptables模拟验证生效。
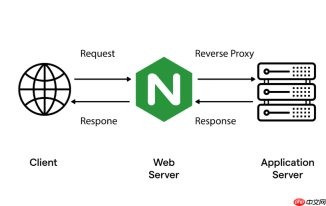
遇到偶发性硬件故障,不能靠权重本身来“踢出”,因为 weight 只控制流量比例,不参与健康判定。真正起作用的是被动健康检查机制——它能在故障首次暴露时就快速响应,而不是等多次失败才动作。
用低阈值 + 短窗口精准捕获偶发故障
偶发故障(比如磁盘短暂卡顿、CPU 瞬时锁死)容易被默认参数过滤掉。应主动调低容错门槛:
- max_fails=1:只要一次连接拒绝、超时或返回 5xx,就立即标记为 down
- fail_timeout=10s:10 秒内只统计这一次失败,不拉长窗口稀释影响;同时该节点被隔离 10 秒,避免连续打过去
- 搭配 proxy_connect_timeout 3s; proxy_read_timeout 3s;,确保失败能秒级判定,不因默认 60 秒读超时拖慢剔除节奏
必须启用 proxy_next_upstream 并覆盖全部失败类型
仅设 max_fails 不生效,必须让每次失败都计入计数并触发重试:

- 在 location 块中写全:proxy_next_upstream error timeout http_500 http_502 http_503 http_504;
- 特别注意加上 error(底层连接失败)和 timeout(含 connect 和 read 超时),这两类最常出现在硬件抖动场景
- 避免漏掉 http_504 —— 它代表 Nginx 等待后端响应超时,往往是网卡或中断异常的信号
配合 backup 节点做兜底,防止误判雪崩
过于敏感的配置可能因网络抖动误踢,需加一层缓冲:
- 在 upstream 中显式声明一个 backup 节点,例如:server 192.168.1.99:8080 backup;
- 当主节点因 max_fails=1 被标记 down 后,流量自动切到 backup;若 backup 也异常,Nginx 会继续尝试已 down 的主节点(作为最后试探)
- 这样既保证快速隔离,又避免单点误判导致全量 502
验证是否真起效:手动模拟+日志盯梢
配完别信配置,要实测:
- 临时在目标机器上执行 iptables -A OUTPUT -p tcp --dport 8080 -j REJECT 模拟硬件级连接拒绝
- 立刻发一个 curl 请求,观察 access.log 是否打到其他节点,error.log 是否出现 upstream failed (111: Connection refused)
- 10 秒后再次请求,确认该节点是否仍被跳过;再等 10 秒后第三次请求,看是否自动恢复(即“试探成功”逻辑生效)


