





nginx上游全宕时默认返回简陋503,需通过proxy_next_upstream、proxy_intercept_errors、error_page和internal location拦截并返回自定义503页面,同时添加retry-after头提升专业性。
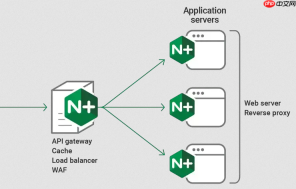
在 Nginx 轮询(upstream)场景下,当所有后端服务都不可用时,Nginx 默认返回 503 Service Temporarily Unavailable 页面,内容简陋且不友好。要提升用户体验,关键不是“修改轮询算法”,而是**拦截由 upstream 失败触发的 503,并用自定义页面接管响应**。这需要结合 proxy_next_upstream、error_page 和内部 location 配置完成。
确保上游失败能触发 503 并被拦截
Nginx 不会自动为 upstream 全挂生成 503——它默认直接报错或透传后端错误。必须显式启用失败重试与兜底机制:
- 在
upstream块中设置fail_timeout=0和合理max_fails,但更重要的是开启proxy_next_upstream error timeout http_500 http_502 http_503 http_504;(放在 server 或 location 内) - 添加
proxy_intercept_errors on;—— 这是前提,否则 Nginx 不会接管后端返回的错误状态码 - 配置
error_page 503 /503.html;,将 503 映射到本地静态页
提供安全可用的自定义 503 页面
页面文件(如 /usr/share/nginx/html/503.html)需提前准备,内容应说明“服务暂不可用”“正在维护”“稍后重试”等友好提示,并可加入倒计时或自动刷新逻辑。配置对应 location 时务必加 internal:

location = /503.html { root /usr/share/nginx/html; internal; }-
internal防止用户直接访问/503.html,只允许通过error_page触发 - 路径中的
root必须指向实际存放该 HTML 文件的目录
增强专业性:返回标准 503 + Retry-After 头
搜索引擎和客户端依赖 Retry-After 判断重试时机。可在 location 中手动添加:
location = /503.html { root /usr/share/nginx/html; internal; add_header Retry-After "60"; }- 这会让浏览器和爬虫知道 60 秒后可重试,避免频繁刷屏请求
- 若需更精确时间(如指定 GMT 时间),可写成
add_header Retry-After "Fri, 25 Jul 2026 10:00:00 GMT";
可选进阶:区分维护态与故障态
若网站有计划维护,可配合外部开关(如一个临时文件或变量)动态返回不同 503 页:
- 用
map指令监听维护标志:map $upstream_http_content_type $is_maintenance { "~maintenance" 1; default 0; } - 再用
error_page 503 = @maintenance;+location @maintenance { return 503 '{"status":"maintenance"}'; add_header Content-Type application/json; } - 这样 API 客户端收到 JSON,网页用户看到 HTML,体验更统一


