





k-means聚类属于一种典型的无监督学习算法,其核心思想是根据样本在多个维度上的数值特征,通过计算样本间的距离度量,将数据自动划分为k个互斥的簇。本文将系统讲解如何借助python完成k-means聚类分析的全流程操作与关键实践要点,助力读者高效掌握该方法的实际应用。
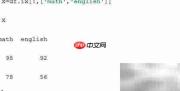
1、 利用pandas库读取学生学业成绩数据集,其中涵盖数学与英语两门科目的分数信息。
2、 导入scikit-learn中提供的KMeans类,作为实现聚类建模的核心工具。
3、 在数据预处理阶段,若原始数据中已存在类别标签,可将其单独提取用于后续效果评估;但需注意,K-means本身不依赖任何标签信息进行训练——它仅基于特征矩阵X完成建模,这正是其适用于无监督任务的本质特征。
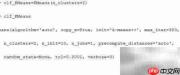
4、 构建KMeans模型时,通过n_clusters参数明确指定期望划分的簇数K,本例设定为2。
5、 其他超参数均采用默认配置,用户可根据具体问题灵活调整以优化聚类性能。

SkillSub Pro - Python 题解与代码注释双功能技能功能概述SkillSub Pro - Python 题解与代码注释双功能技能是一项面向实际任务的技能,主要用于SkillSub Pro 是一个 Python 题解生成与代码注释的 双功能合体技能 ,专为学生、算法学习者和开发者设计;✅ 一个技能,两种用途 :;核心要点📝 题解模式 :输入题目/题号,自动生成完整 Python 题解(含详细注释、解题思路、复杂度分析);💬 注释模式 :输入 Python 代码,自动添加详细中。它将相关步骤、
6、 调用fit方法对数据进行训练,并使用predict或fit_predict获取每个样本所属的簇标签。
7、 输出结果显示所有样本被稳定地分配至两个不同的簇中。
8、 基于预测结果,结合matplotlib绘制二维散点图,不同簇以颜色区分。
9、 由于当前样本规模较小且类别边界模糊,导致二分类下的聚类结构不够清晰直观。
10、 尝试增大K值(如设为3或4),重新运行聚类并可视化结果。
11、 观察图表可知,提升簇数量后,样本分组更加合理,聚类轮廓更趋明显。在实际应用中,应综合考虑数据规模、业务目标及评估指标(如肘部法则、轮廓系数等)来科学确定最优K值。
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!






